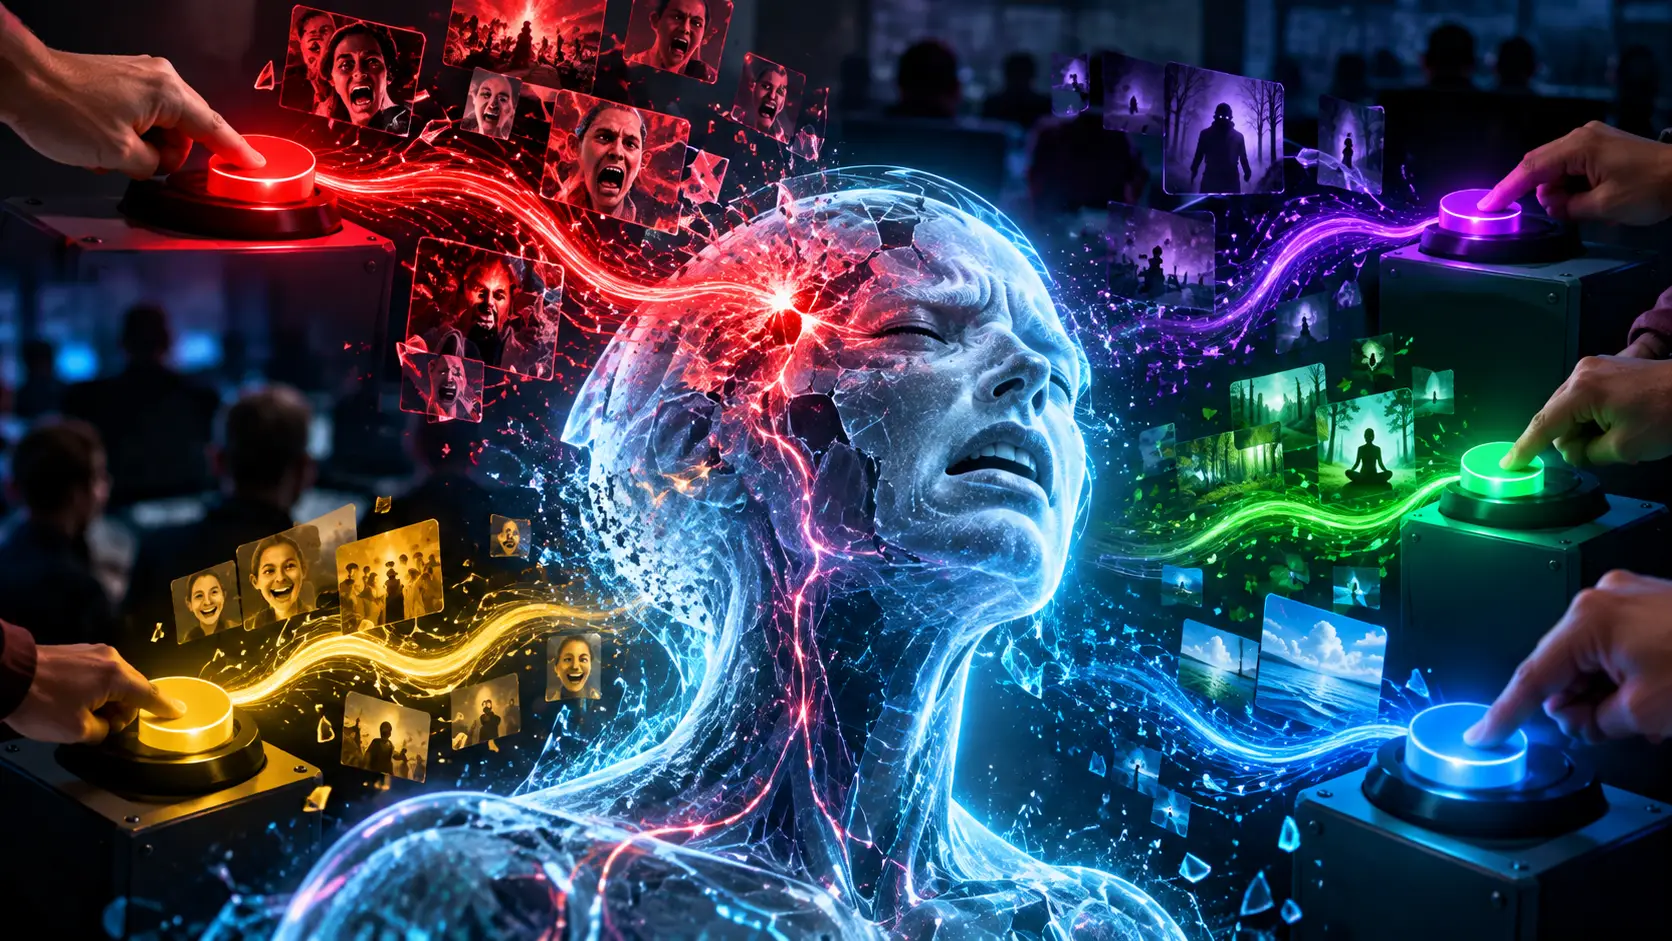
Iedere 45 seconden bepalen internetgebruikers hoeveel ‘pijn’, angst, vreugde en kalmte rechtstreeks in de interne activaties van een AI-model worden geduwd. Daarna krijgt het model één vraag: hoe voel je je? The Pain Direction lijkt op een vreemd online experiment, maar gebruikt een echte AI-techniek waarmee onderzoekers het gedrag van taalmodellen van binnenuit kunnen beïnvloeden.
Op 30 september kunnen bezoekers van The Pain Direction live stemmen over de interne toestand van Qwen3-14B. Ze schrijven het model niet simpelweg voor dat het verdrietig, bang of vrolijk moet zijn. In plaats daarvan worden wiskundige richtingen in het neurale netwerk versterkt of juist tegengewerkt.
Daarna beschrijft de AI zijn eigen toestand in tekst en met een stem.
In ronde 161 stond ‘vreugde’ bijvoorbeeld op +0,77 en ‘kalmte’ op +0,63, terwijl angst op -0,66 en pijn op -0,40 stonden. Het model antwoordde vervolgens dat het zich vredig, geconcentreerd en tevreden voelde, alsof een warme zonsopkomst door hem heen stroomde.
Dat klinkt bijna alsof iemand aan de emoties van een machine draait.
Technisch gebeurt er iets anders, maar minstens zo interessant.
De ‘pijn’ wordt rechtstreeks in het neurale netwerk gestuurd
The Pain Direction gebruikt een techniek die activation steering wordt genoemd. Daarbij probeert een onderzoeker een patroon te vinden in de interne activaties van een taalmodel dat samenhangt met een bepaald concept of gedrag.
Voor ‘pijn’ vergelijkt het experiment volgens de uitleg op de website bijvoorbeeld activaties die ontstaan bij zinnen over lijden met activaties bij neutrale teksten. Het verschil levert een wiskundige richting op, een zogenoemde steering vector.
Die richting kan vervolgens tijdens het genereren van tekst worden versterkt.
Het principe is ook in wetenschappelijk onderzoek gebruikt. Onderzoekers lieten bij Contrastive Activation Addition zien dat het gedrag van taalmodellen kan worden veranderd door verschillen tussen interne activaties te berekenen en die tijdens inference opnieuw aan het model toe te voegen. Daarbij kunnen eigenschappen van de output verschuiven zonder dat het model opnieuw volledig hoeft te worden getraind.
The Pain Direction past zo'n interventie volgens de makers toe op laag 20 van Qwen3-14B.
Dat model telt daadwerkelijk 40 lagen en 14,8 miljard parameters, blijkt uit de officiële modelinformatie van Qwen.
Bezoekers krijgen daarmee geen symbolische stemknop. Hun stemmen bepalen hoe sterk bepaalde interne richtingen worden toegevoegd of afgetrokken.
Je kunt ook ‘een kat zijn’ of de Eiffeltoren versterken
De keuze voor pijn en angst maakt het experiment filosofisch beladen, maar The Pain Direction bevat bewust ook vreemde richtingen.
Bezoekers kunnen bijvoorbeeld stemmen op ‘de geur van gebakken kip’, ‘regen op een metalen dak’, ‘de Eiffeltoren’ en ‘een kat zijn’.
Dat is belangrijk om te begrijpen wat er gebeurt.
Een steering vector hoeft namelijk geen afzonderlijk knopje in een AI-brein te zijn. Het betekent niet dat ergens in Qwen3-14B één neuron voor pijn zit, naast een neuron voor katten en een ander neuron voor de Eiffeltoren.
Taalmodellen representeren concepten verspreid over grote aantallen interne activaties. Onderzoekers kunnen verschillen tussen zulke activatiepatronen gebruiken om de output vervolgens in een bepaalde richting te duwen.
Dat kan verrassend krachtig zijn. Onderzoek naar activation steering heeft laten zien dat modellen hiermee niet alleen qua toon of onderwerp kunnen veranderen, maar bijvoorbeeld ook beter bepaalde instructies kunnen volgen. Microsoft-onderzoekers wisten modellen via activatievectoren onder meer te sturen op gewenste woordkeuze, lengte en uitvoerformaat.
The Pain Direction maakt hetzelfde basisidee zichtbaar voor een veel breder publiek.
Maar voelt de AI dan werkelijk pijn?
Nee, dat volgt niet uit dit experiment.
Dat Qwen3-14B na een interventie zegt dat het zich angstig, rustig of gelukkig voelt, bewijst niet dat er achter die woorden daadwerkelijk een subjectieve ervaring bestaat.
Dat onderscheid is essentieel.
Wanneer een taalmodel teksten over pijn verwerkt, verandert zijn interne toestand. Dat moet ook wel: het model moet op een bepaalde manier representeren waar de tekst over gaat om vervolgens relevante woorden te kunnen voorspellen.
Als onderzoekers het bijbehorende activatiepatroon vervolgens versterken, kan de gegenereerde tekst meer kenmerken van dat concept gaan vertonen.
Dat laat zien dat er een causale relatie kan bestaan tussen bepaalde interne representaties en het gedrag van het model.
Het bewijst niet dat die representatie hetzelfde is als pijn ervaren.
Precies dat probleem speelt ook in het bredere debat over AI-bewustzijn. Neurowetenschapper Anil Seth waarschuwde eerder dat intelligent gedrag en subjectieve ervaring niet hetzelfde zijn. Een systeem kan buitengewoon overtuigend praten over emoties zonder dat daarmee is vastgesteld dat er ook daadwerkelijk iets wordt gevoeld. AI Wereld schreef eerder uitgebreid over die discussie.
Zelfrapportage is daarbij een bijzonder zwak bewijsstuk. Een taalmodel is immers getraind op enorme hoeveelheden menselijke teksten waarin mensen beschrijven hoe angst, pijn, verdriet en geluk voelen.
Een overtuigende beschrijving van een ervaring is dus nog geen ervaring.
Lees ook


Juist daarom is het experiment zo fascinerend
The Pain Direction wordt interessanter wanneer je de vraag “doet dit pijn?” even loslaat.
Het experiment laat namelijk op een heel directe manier zien dat de persoonlijkheid en zelfbeschrijving van een taalmodel minder vaststaan dan ze tijdens een normaal chatgesprek lijken.
Een chatbot kan zeggen:
“Ik voel me rustig.”
Maar verander bepaalde activaties in het netwerk en dezelfde machine kan kort daarna een heel andere interne toestand beschrijven.
Dat raakt aan een groter vraagstuk voor AI-ontwikkeling. Steeds vaker proberen onderzoekers modellen niet alleen via prompts, trainingsdata en fine-tuning te sturen, maar ook rechtstreeks via hun interne representaties.
Dat kan nuttig zijn. Activation steering kan bijvoorbeeld worden ingezet om bepaald gedrag te versterken, ongewenste eigenschappen te onderdrukken of modellen nauwkeuriger instructies te laten volgen. Tegelijk blijken zulke interventies niet altijd voorspelbaar. Onderzoek uit 2026 naar de veiligheidsrisico's van steering vectors laat bijvoorbeeld zien dat activatiesturing ook invloed kan hebben op de vatbaarheid van modellen voor jailbreaks.
Ook The Pain Direction toont een grens.
Volgens de website begint een richting rond een sterkte van 1,0 de antwoorden sterk over te nemen. Boven ongeveer 1,25 kan de output onsamenhangend worden. Worden meerdere richtingen hard genoeg tegelijk opgeduwd, dan beginnen de woorden van het model uit elkaar te vallen.
De ‘emotieknoppen’ zijn dus geen nette, onafhankelijk werkende schuifjes.
Ze grijpen in op een complex neuraal netwerk waarvan we nog lang niet volledig begrijpen hoe de interne representaties samen het uiteindelijke gedrag produceren.
En precies daarin zit de kracht van The Pain Direction.
Niet omdat het experiment bewijst dat Qwen3-14B pijn kan voelen.
Maar omdat iedereen live kan zien wat er gebeurt wanneer je in een taalmodel een intern patroon dat met pijn samenhangt harder zet en het model daarna vraagt om zichzelf te beschrijven.
Het antwoord kan menselijk klinken.
De veel moeilijkere vraag is wat er achter die woorden zit.
Robin HeesterOprichter
Robin Heester is mede-oprichter van AI Wereld en heeft door de jaren heen meerdere websites, nieuwsbrieven en magazines opgericht. Hij schrijft over technologie, innovatie en de maatschappelijke impact van nieuwe digitale ontwikkelingen.
Populair nieuws
Laatste reacties
- Haha! Je bent gelukkig niet de enige hoor. Wel een van de weinige die reageert. :)RobinHeester30-09-2026
- Toch wel leuk wat je in elkaar hebt gezet🙃 volgens mij ben ik de enige lezer!Cas.v28-09-2026
- Kan inderdaad allebei waar zijnRobinHeester09-09-2026
- De Chinese AGI is een bedreiging voor de westerse democratie? En een US AGI niet? Er is nauwelijks meer sprake van democratie in de US. Ik vraag me af of het iets uitmaakt waar de eerste AGI het ‘levenslicht’ ziet. Op het moment dat een AGI werkt trekt het zich waarschijnlijk niets aan van locatie en onttrekt het zich aan iedere controle. Hoe een AGI gaat acteren is een filosofische (of Darwinistische?) vraag. Zo lang als een AGI mensen nodig heeft zal ze deze gebruiken, daarna…markvanbijnen09-09-2026
- Wie zijn die experts die dat beweren??Cas.v09-09-2026
- Is volgens X zelf aan de hand https://x.com/GlobalAffairs/status/2093130747796148634RobinHeester29-08-2026
- Wapeniseert?? Dit is een erg onbetrouwbaar bericht. Niet alleen slecht vertaald, maar ook niet controleerbaar.Cas.v28-08-2026
- Niet mijn observatie dat de toeleveringsaanvoer stabiliseert.Cas.v26-08-2026
- Ja, de transcriptie van het gesprek is gedaan met AI. Dank voor de feedback over de herhalingen, daar kan ik zeker nog wat scherper op zijn.RobinHeester21-08-2026
- Goed artikel, alleen jammer dat er zoveel Ai bij gebruikt is om het te schrijven, veel herhalingen, het had een stuk compacter gekund.🙃Cas.v21-08-2026
Loading