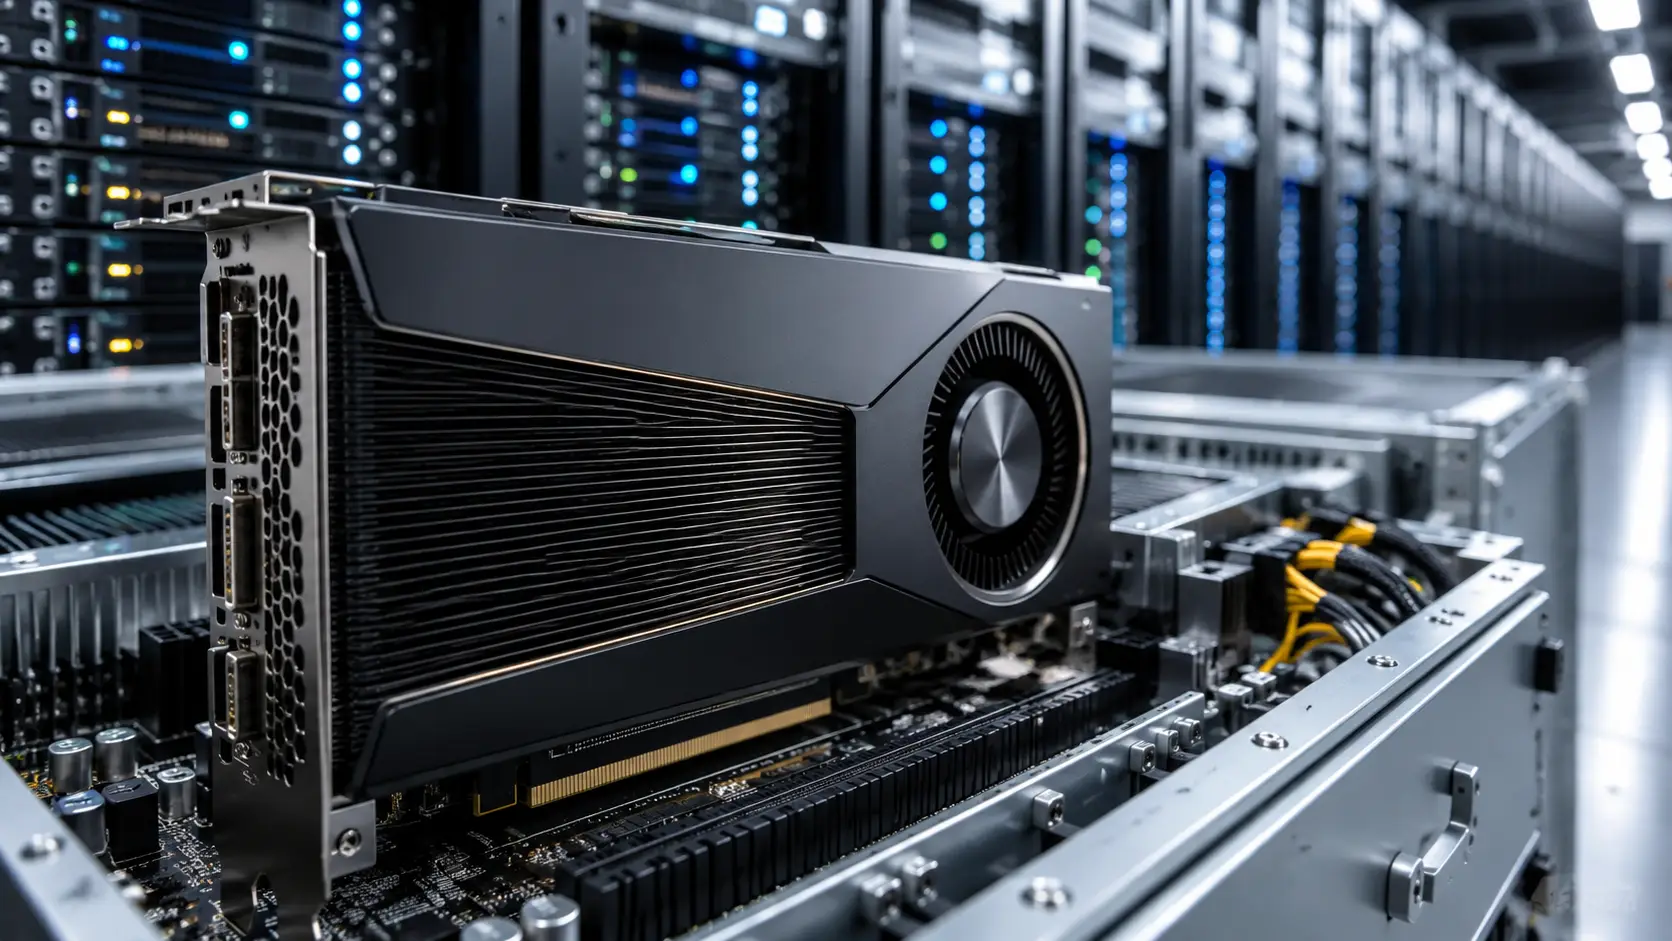
De graphics processing unit, een chip ontworpen om pixels te renderen en polygonen over een scherm te duwen, is stilletjes uitgegroeid tot het belangrijkste onderdeel van de AI-infrastructuur.
Ooit beperkt tot gaming-pc’s en werkstations, vormt de GPU nu het hart van AI-datacenters die stroom verbruiken als hele stadswijken, waar de grote taalmodellen en generatieve AI-systemen worden getraind die sectoren van zorg tot financiën hervormen.
Een graphics processing unit, afgekort tot GPU, is een processor die veel vergelijkbare berekeningen gelijktijdig kan uitvoeren. GPU’s werden groot door computergraphics, maar hun parallelle ontwerp past ook bijzonder goed bij de wiskunde achter neurale netwerken. Daardoor vormen ze een belangrijk onderdeel van moderne AI-computers en datacenters.
Dat betekent niet dat iedere AI-taak een GPU nodig heeft of dat een GPU altijd sneller is dan een CPU. Het voordeel ontstaat vooral wanneer een probleem kan worden opgesplitst in heel veel vergelijkbare bewerkingen. Precies dat gebeurt bij het trainen en uitvoeren van grote neurale netwerken.
Wat is een GPU?
Een GPU is een gespecialiseerde processor voor parallel rekenwerk. Bij het tekenen van een 3D-wereld moet een computer voor grote aantallen pixels en objecten soortgelijke bewerkingen uitvoeren: posities transformeren, kleuren berekenen, licht simuleren en texturen verwerken. Die taken kunnen grotendeels tegelijk plaatsvinden.
Een CPU is juist ontworpen als flexibele alleskunner. Hij verwerkt het besturingssysteem, programmalogica, invoer, databases en allerlei taken met veel vertakkingen. Een moderne CPU heeft relatief weinig krachtige cores met grote caches en geavanceerde besturing. Een GPU verdeelt zijn chipoppervlak over veel meer rekeneenheden en is gebouwd voor doorvoer.
De vergelijking “CPU is slim, GPU is dom maar snel” is te eenvoudig. Beide zijn complexe processors. Het wezenlijke verschil is waar het ontwerp op wordt geoptimaliseerd:
| Eigenschap | CPU | GPU |
| Sterk in | Lage wachttijd en uiteenlopende taken | Hoge doorvoer bij parallel werk |
| Rekenkernen | Relatief weinig, krachtige cores | Veel kleinere rekeneenheden |
| Programmalogica | Goed met vertakkingen en sequentiële stappen | Goed met herhaalde, gelijksoortige bewerkingen |
| Geheugen | Grote caches, lage latency | Hoge bandbreedte naar veel data |
| Rol bij AI | Orkestratie, data, preprocessing en algemene code | Matrixberekeningen, training en inference |
In een AI-systeem werken CPU en GPU meestal samen. De CPU bereidt werk voor, leest data en bestuurt het proces. De GPU voert de zware parallelle berekeningen uit.
Waarom bestaat AI uit zoveel parallel rekenwerk?
Een neuraal netwerk bestaat uit lagen met grote verzamelingen getallen, ook wel parameters genoemd. Wanneer data door zo’n model stroomt, worden waarden met elkaar vermenigvuldigd, opgeteld en door activatiefuncties gestuurd. Veel van deze bewerkingen worden als matrixvermenigvuldigingen uitgevoerd.
Een matrix is een rechthoekig rooster van getallen. Bij een grote vermenigvuldiging moeten enorme aantallen kleine rekenstappen worden uitgevoerd. Omdat veel stappen onafhankelijk van elkaar zijn, kunnen duizenden rekeneenheden er tegelijk aan werken.
GPU’s waren al gebouwd voor een vergelijkbaar patroon in graphics. De overgang naar AI vergde nieuwe software en gespecialiseerde instructies, maar niet een volledig nieuw basisidee. Nvidia maakte algemene GPU-berekeningen toegankelijker met CUDA; andere leveranciers ontwikkelden eigen softwarelagen en accelerators.
Training en inference zijn niet hetzelfde
AI gebruikt GPU’s in twee belangrijke fasen.
Training
Tijdens training leert een model uit voorbeelden. Het systeem doet een voorspelling, meet de fout en past parameters aan. Daarvoor moeten niet alleen voorwaartse berekeningen, maar ook gradients en optimizerstappen worden verwerkt. Training vraagt daardoor veel rekenkracht, geheugen en communicatie tussen chips.
Bij grote modellen wordt het werk verdeeld over honderden of duizenden accelerators. Sommige chips verwerken delen van de data, andere delen van het model. Een snel netwerk is nodig om tussentijdse resultaten te synchroniseren. Daarom is een trainingscluster veel meer dan een stapel losse videokaarten.
Inference
Inference is het gebruiken van een getraind model. Wanneer iemand een prompt naar een taalmodel stuurt, berekent het systeem stap voor stap welke tokens waarschijnlijk volgen. Per verzoek is minder werk nodig dan voor een volledige training, maar een populaire dienst kan miljoenen verzoeken verwerken.
Inference kent verschillende optimalisatiedoelen:
- lage latency: één gebruiker snel antwoord geven;
- hoge throughput: veel verzoeken tegelijk verwerken;
- lage kosten: zo min mogelijk energie en hardware per antwoord;
- voldoende geheugen: modelgewichten en tijdelijke data beschikbaar houden;
- voorspelbaarheid: een afgesproken responstijd halen.
Een GPU die goed is voor training is niet automatisch de beste of voordeligste keuze voor iedere inference-workload.
Wat doen tensorcores?
Moderne AI-GPU’s bevatten gespecialiseerde rekeneenheden voor matrixoperaties. Nvidia noemt deze tensorcores. Ze voeren bepaalde matrixberekeningen efficiënter uit dan algemene GPU-cores.
Tensorcores werken met verschillende numerieke formaten. Een getal kan met veel of weinig bits worden opgeslagen. Hogere precisie biedt meer detail, maar vraagt meer geheugen en rekenwerk. Voor veel AI-stappen kan een lager formaat worden gebruikt zonder dat het model onbruikbaar wordt.
Veel voorkomende aanduidingen zijn:
- FP32: 32-bits floating point, traditioneel veel gebruikt voor nauwkeurig rekenwerk;
- TF32: Nvidia-formaat dat delen van FP32-berekeningen versnelt;
- FP16 en BF16: 16-bits formaten die training en inference efficiënter maken;
- FP8 en FP4: lagere precisie voor geschikte moderne AI-workloads;
- INT8 en INT4: gehele getallen, vaak gebruikt bij quantisatie en inference.
Een vergelijking op basis van alleen “AI-TOPS” of “petaFLOPS” kan misleidend zijn. Een fabrikant kan het gunstigste formaat, sparsity en een theoretische piek vermelden. De echte prestatie hangt af van het model en de software.
Waarom zijn VRAM en geheugenbandbreedte zo belangrijk?
De GPU moet data snel kunnen bereiken. Op een losse videokaart staat die data in videogeheugen, of VRAM. Dat geheugen bepaalt mede welke modellen en batchgroottes passen.
Geheugencapaciteit
Als een model niet volledig in het beschikbare geheugen past, zijn er verschillende mogelijkheden:
- een kleinere of sterker gequantiseerde versie gebruiken;
- delen naar systeemgeheugen of opslag verplaatsen;
- het model over meerdere GPU’s verdelen;
- een kleinere context of batchgrootte kiezen.
Deze oplossingen hebben gevolgen voor snelheid en complexiteit. Daarom is meer VRAM vaak waardevoller voor lokale AI dan een kleine winst in theoretische rekenkracht.
Geheugenbandbreedte
Capaciteit zegt hoeveel data past; bandbreedte zegt hoe snel data kan worden aangevoerd. Bij het genereren van tekst moeten modelgewichten herhaaldelijk worden gelezen. Daardoor kan inference geheugenbeperkt zijn: extra rekeneenheden helpen weinig als ze op data wachten.
Datacenteraccelerators gebruiken vaak HBM, geheugen met een zeer hoge bandbreedte dat dicht bij de processor is geplaatst. Consumentenkaarten gebruiken doorgaans GDDR-geheugen. Beide hebben een andere balans tussen capaciteit, snelheid, kosten en energiegebruik.
Waarom was AlexNet in 2012 belangrijk?
GPU’s werden al vóór 2012 voor wetenschappelijk rekenen en neurale netwerken gebruikt. AlexNet werd echter een zichtbaar keerpunt. Alex Krizhevsky, Ilya Sutskever en Geoffrey Hinton trainden het netwerk op twee Nvidia GTX 580-GPU’s met ieder 3 GB geheugen. De training duurde meerdere dagen en het model won de ImageNet-competitie met een grote voorsprong.
Het succes bewees niet dat alleen Nvidia AI kon uitvoeren. Het liet vooral zien dat grotere neurale netwerken, voldoende data en GPU-rekenkracht samen een sterke sprong in beeldherkenning konden opleveren. Vanaf dat moment verschoof veel onderzoek naar deep learning en GPU-versnelling.
Hoe werken meerdere GPU’s samen?
Eén GPU is begrensd door geheugen, rekenkracht en energie. Grote modellen worden daarom over meerdere chips verdeeld. Dat kan op verschillende manieren:
- data parallelism: iedere GPU verwerkt een ander deel van de trainingsdata;
- tensor parallelism: één grote berekening wordt over meerdere GPU’s gesplitst;
- pipeline parallelism: verschillende modellagen draaien op verschillende chips;
- expert parallelism: onderdelen van een mixture-of-experts-model worden verdeeld.
Zodra GPU’s veel met elkaar moeten communiceren, wordt de verbinding een mogelijke bottleneck. Binnen een server kan NVLink een snellere verbinding bieden dan standaard PCI Express. Tussen servers worden snelle InfiniBand- of Ethernetnetwerken gebruikt.
De Nvidia-chipgids over H100, H200, Blackwell en Rubin legt uit hoe geheugen en interconnects per generatie veranderen. Voor het grotere fysieke geheel is er onze uitleg over AI-datacenters.
Zijn GPU’s altijd de beste keuze voor AI?
Nee. De juiste accelerator hangt af van de taak.
Een CPU kan voldoende zijn voor:
- kleine modellen en lage gebruiksvolumes;
- preprocessing en datatransformatie;
- modellen die slecht paralleliseren;
- situaties waarin opstarttijd en eenvoud belangrijker zijn dan topsnelheid.
Andere opties zijn:
- AMD-GPU’s;
- Google TPU’s;
- AWS Trainium en Inferentia;
- Apple-silicium met gedeeld geheugen;
- FPGA’s of gespecialiseerde inferencechips;
- neurale processors in telefoons en laptops.
GPU’s zijn aantrekkelijk omdat ze breed programmeerbaar zijn. Een gespecialiseerde chip kan efficiënter zijn voor één soort taak, terwijl een GPU meer verschillende workloads ondersteunt.
Waarom heeft Nvidia zo’n sterke positie?
Hardware is maar een deel van het antwoord. Nvidia ontwikkelt al sinds 2006 CUDA als softwareplatform voor GPU-rekenen. Veel frameworks, libraries en onderzoekscode zijn daarop afgestemd.
Daarnaast levert het bedrijf netwerkproducten, complete systemen en enterprise-software. De bredere strategie staat in ons artikel wat is Nvidia?. Voor teams die tussen leveranciers kiezen, is de praktische vergelijking Nvidia versus AMD voor AI relevanter dan alleen een lijst pieksnelheden.
Het huidige GPU-landschap en de machtsstrijd
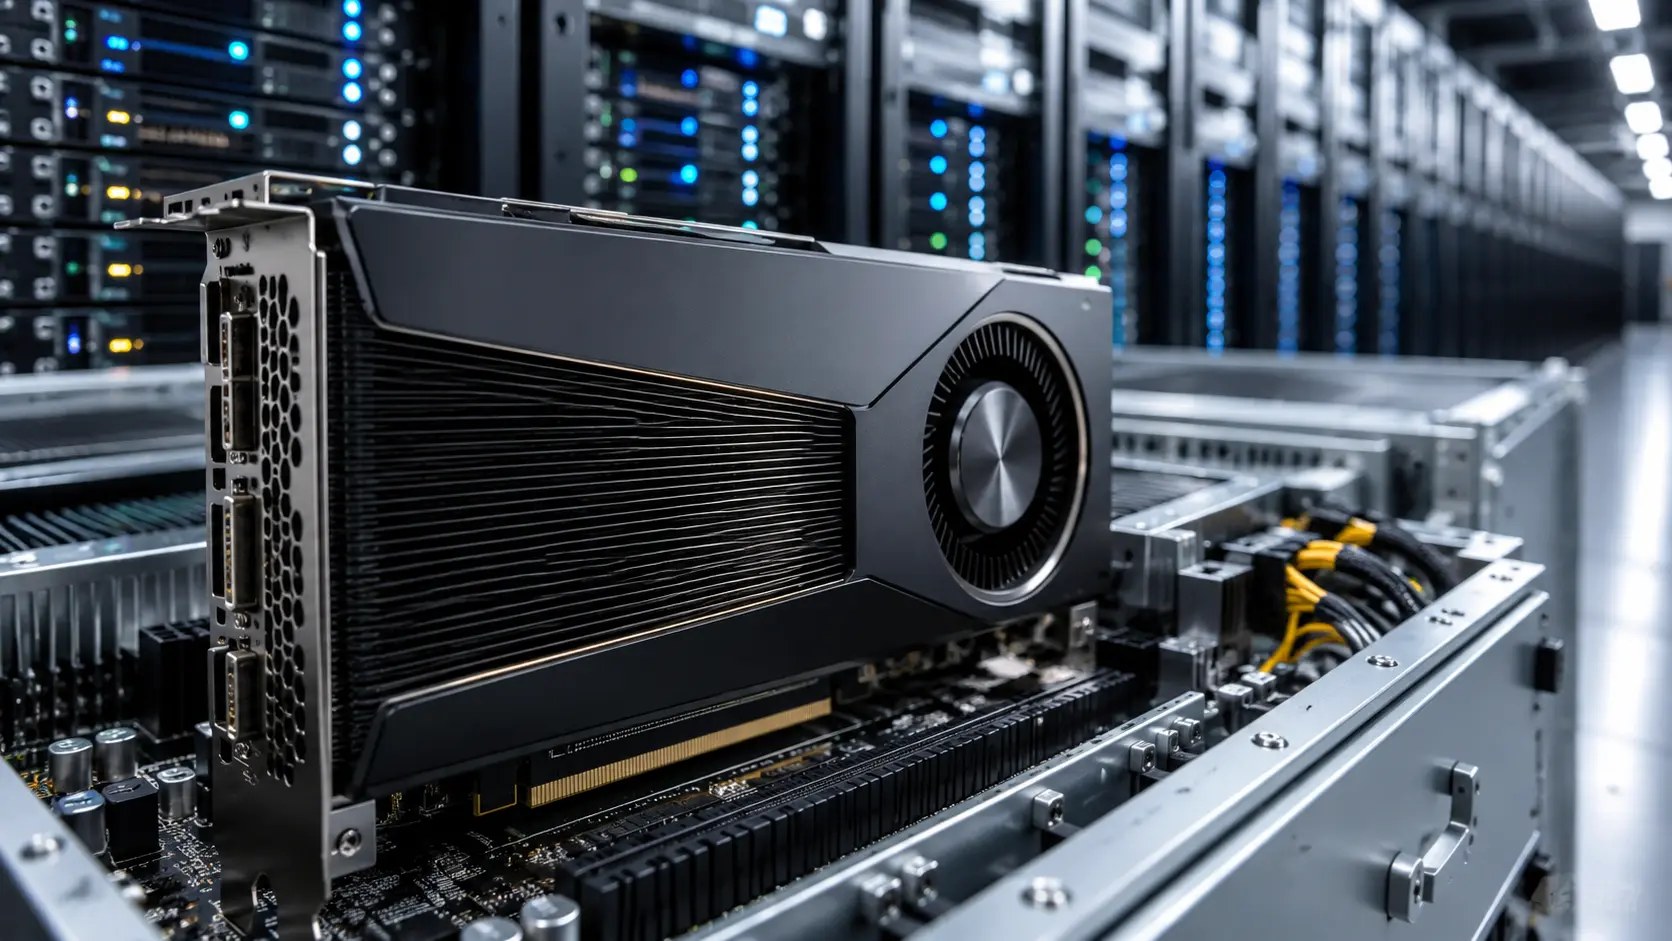
Vandaag domineert Nvidia de AI-chipmarkt met de H100 en de recentere B200 Blackwell-GPU’s, speciaal gebouwd voor de eisen van grootschalige AI-training en -inference. Een enkele Nvidia H100, geprijsd rond $30.000 (£24.000), levert 4 petaFLOPS aan AI-prestaties. Datacenters stapelen nu duizenden van deze chips in clusters die tientallen megawatt aan stroom verbruiken.
Concurrenten voeren het tempo op om deze dominantie uit te dagen. AMD’s Instinct MI300X boekt terreinwinst bij cloudproviders, terwijl Google’s Tensor Processing Units (TPU’s) – maatwerksilicium speciaal voor AI-workloads – een propriëtair alternatief bieden. Ook Intel schuift op met zijn Gaudi-acceleratorlijn.
Toch blijven GPU’s, ondanks alle nieuwkomers, de lingua franca van de AI-infrastructuur. Hun combinatie van parallelle rekenkracht, volwassen software via platforms als CUDA en de diepte van het ecosysteem maakt ze de standaardkeuze voor het trainen van grensverleggende modellen.
Van het renderen van fantasielandschappen in videogames tot het trainen van systemen die code kunnen schrijven, ziekten kunnen diagnosticeren en kunst kunnen genereren: de GPU heeft een tocht afgelegd naar een van de meest bepalende keerpunten in de geschiedenis van het computeren. Wat begon als een specialistische chip voor consumentenentertainment werd de cruciale infrastructuur van een technologische omwenteling.
Naarmate AI-modellen groter en capabeler worden, lijkt de vraag naar GPU-rekenkracht niet te vertragen. Als AI het brein van dit nieuwe tijdperk is, dan is de GPU onmiskenbaar de spierkracht.
Welke GPU heb je nodig voor lokale AI?
Voor lokaal gebruik begint de keuze bij de workload:
- tekst genereren met een klein taalmodel;
- beeldgeneratie;
- spraakherkenning;
- lokaal zoeken in documenten;
- finetuning of training;
- meerdere gebruikers of modellen tegelijk.
Daarna kijk je naar VRAM, geheugenbandbreedte, softwareondersteuning, stroomverbruik, koeling en budget. Een kaart met 16 GB kan praktischer zijn dan een iets snellere kaart met 8 GB als het gewenste model anders niet past.
Bij systemen met coherent unified memory, zoals DGX Spark en RTX Spark, is het geheugencijfer anders opgebouwd dan VRAM op een losse videokaart. Vergelijk daarom capaciteit, bandbreedte, processorarchitectuur en softwareondersteuning afzonderlijk.
De concrete actuele modellen en VRAM-klassen staan in de koopgids voor Nvidia-GPU’s voor lokale AI.
De beperkingen van GPU’s
GPU-versnelling heeft duidelijke nadelen:
- krachtige kaarten en datacenteraccelerators zijn duur;
- het stroomverbruik en de warmteproductie zijn hoog;
- software moet de hardware efficiënt kunnen benutten;
- een grotere GPU maakt een slecht model of slechte data niet automatisch beter;
- prestaties uit benchmarks zijn niet altijd representatief voor een eigen toepassing;
- afhankelijkheid van één softwareplatform kan overstappen moeilijk maken.
Ook efficiëntie vraagt context. Een nieuwe GPU kan per berekening minder energie gebruiken, maar het totale verbruik stijgt wanneer organisaties veel meer modellen en verzoeken draaien.
Conclusie
GPU’s zijn belangrijk voor AI omdat hun parallelle architectuur past bij de matrixberekeningen in neurale netwerken. Gespecialiseerde rekeneenheden, snel geheugen en verbindingen tussen chips vergroten dat voordeel.
Toch is “meer GPU” geen volledig antwoord. Training en inference stellen andere eisen. Geheugen kan belangrijker zijn dan theoretische rekenkracht, software bepaalt hoeveel van de hardware wordt benut en een CPU of gespecialiseerde accelerator kan voor sommige taken beter passen.
Wie een GPU vergelijkt, moet daarom minimaal naar workload, geheugencapaciteit, bandbreedte, precisie, softwareondersteuning en totale kosten kijken.
Veelgestelde vragen over GPU’s en AI
Wat betekent GPU?
GPU staat voor graphics processing unit. Het is een processor die is geoptimaliseerd voor veel parallelle berekeningen.
Waarom is een GPU sneller voor AI dan een CPU?
Veel AI-berekeningen kunnen gelijktijdig worden uitgevoerd. Een GPU heeft veel rekeneenheden en een hoge geheugendoorvoer, waardoor hij zulke parallelle taken efficiënt verwerkt. Voor sequentiële logica blijft een CPU vaak geschikter.
Is VRAM hetzelfde als RAM?
Nee. VRAM is geheugen dat direct bij een losse GPU hoort. Systeem-RAM wordt door de CPU gebruikt. Sommige geïntegreerde systemen hebben gedeeld geheugen, maar capaciteit en bandbreedte zijn dan anders georganiseerd dan bij een desktop-GPU.
Heb je een GPU nodig om ChatGPT te gebruiken?
Niet op je eigen apparaat. Bij een clouddienst zoals ChatGPT draait het model op infrastructuur van de aanbieder. Alleen voor lokale modellen of eigen AI-workloads kan een lokale GPU nodig zijn.
Wat is het verschil tussen training en inference?
Tijdens training leert een model door parameters aan te passen. Inference is het gebruiken van het getrainde model om een voorspelling of antwoord te genereren.
Kan AI op een gewone laptop draaien?
Ja, vooral kleinere of gequantiseerde modellen. De snelheid en maximale modelgrootte hangen af van processor, GPU of NPU, beschikbaar geheugen en softwareondersteuning.
Karthek IyerEditor
Karthek Iyer is Senior Writer en Editor bij AI World Today & AI Wereld, waar hij schrijft over AI-infrastructuur, technologiebedrijven en het SaaS-ecosysteem in wereldwijde markten.
Laatste reacties
- Haha! Je bent gelukkig niet de enige hoor. Wel een van de weinige die reageert. :)
 RobinHeester30-09-2026
- Toch wel leuk wat je in elkaar hebt gezet🙃 volgens mij ben ik de enige lezer!Cas.v28-09-2026
- Kan inderdaad allebei waar zijnRobinHeester09-09-2026
- De Chinese AGI is een bedreiging voor de westerse democratie? En een US AGI niet? Er is nauwelijks meer sprake van democratie in de US. Ik vraag me af of het iets uitmaakt waar de eerste AGI het ‘levenslicht’ ziet. Op het moment dat een AGI werkt trekt het zich waarschijnlijk niets aan van locatie en onttrekt het zich aan iedere controle. Hoe een AGI gaat acteren is een filosofische (of Darwinistische?) vraag. Zo lang als een AGI mensen nodig heeft zal ze deze gebruiken, daarna…markvanbijnen09-09-2026
- Wie zijn die experts die dat beweren??Cas.v09-09-2026
- Is volgens X zelf aan de hand https://x.com/GlobalAffairs/status/2093130747796148634RobinHeester29-08-2026
- Wapeniseert?? Dit is een erg onbetrouwbaar bericht. Niet alleen slecht vertaald, maar ook niet controleerbaar.Cas.v28-08-2026
- Niet mijn observatie dat de toeleveringsaanvoer stabiliseert.Cas.v26-08-2026
- Ja, de transcriptie van het gesprek is gedaan met AI. Dank voor de feedback over de herhalingen, daar kan ik zeker nog wat scherper op zijn.RobinHeester21-08-2026
- Goed artikel, alleen jammer dat er zoveel Ai bij gebruikt is om het te schrijven, veel herhalingen, het had een stuk compacter gekund.🙃Cas.v21-08-2026
Loading