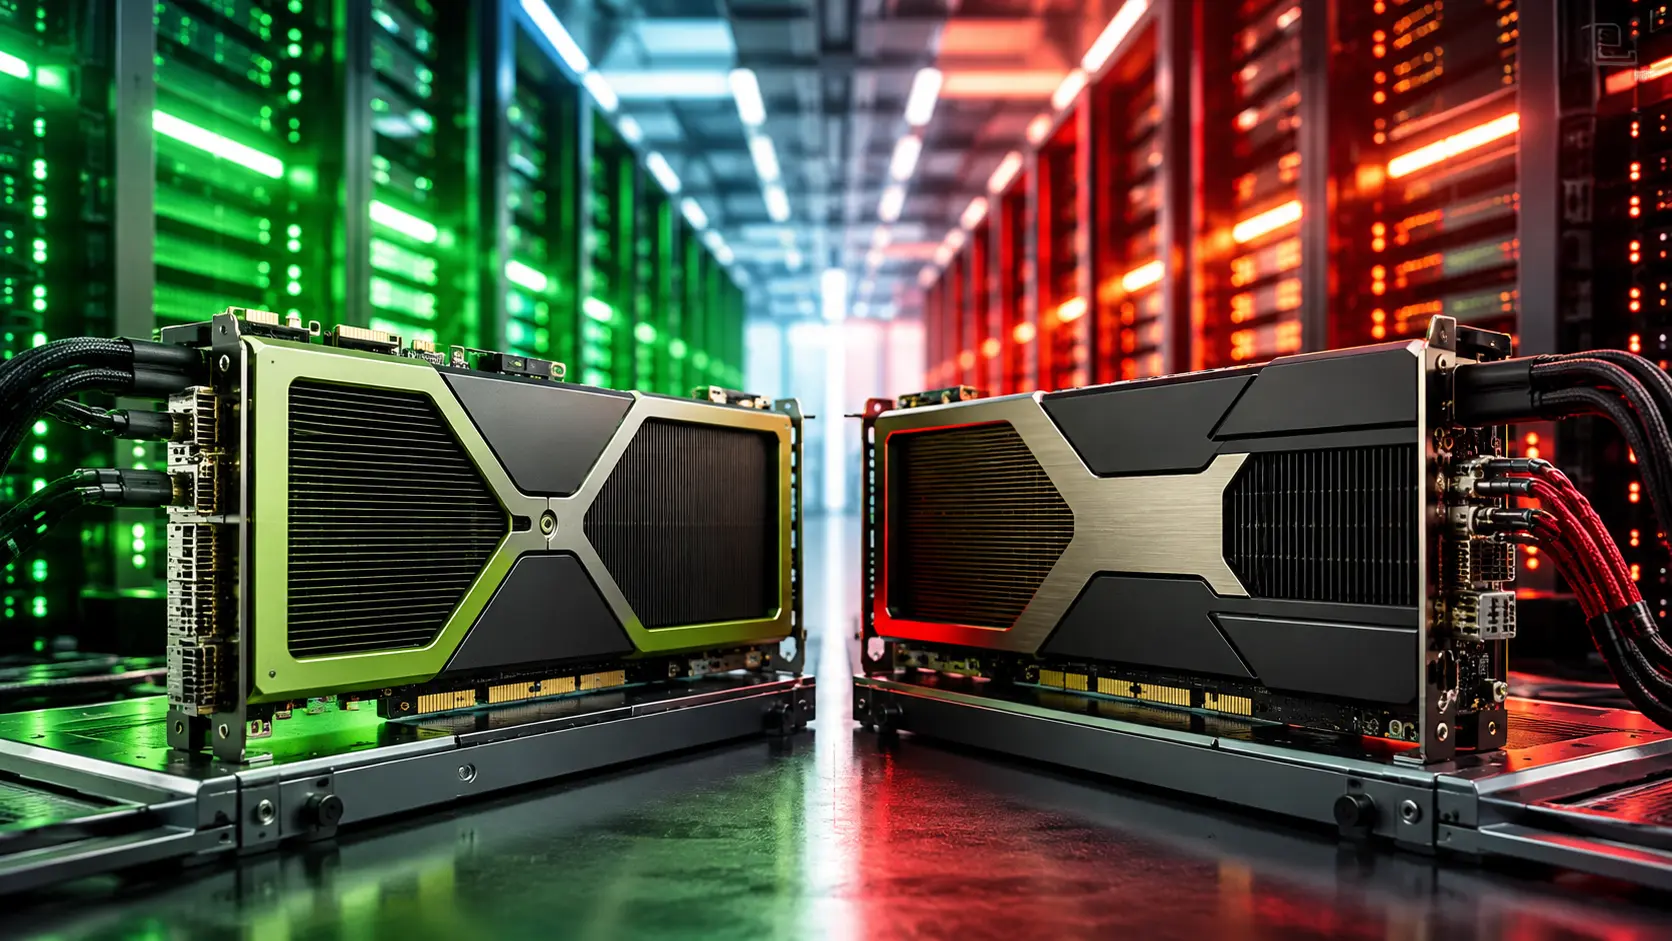
Nvidia is voor veel AI-teams de standaardkeuze door CUDA, brede frameworkondersteuning en een groot aanbod van consumentenkaart tot rack-scale systeem. AMD biedt met Radeon, Instinct en ROCm een serieus alternatief en kan aantrekkelijk zijn door geheugencapaciteit, hardwarekeuze, open software en onderhandelingsruimte.
Er is geen winnaar voor iedere situatie. De beste accelerator is niet de kaart met het hoogste losse benchmarkcijfer, maar het platform dat de gewenste modellen betrouwbaar en tegen de laagste totale kosten uitvoert.
Wie eerst het bedrijf, de productlagen en de bredere strategie wil plaatsen, begint bij onze cornerstone wat is Nvidia?.
Nvidia versus AMD in het kort
| Onderdeel | Nvidia | AMD |
| Belangrijkste AI-software | CUDA en CUDA-X | ROCm en HIP |
| Consumentenlijn | GeForce RTX | Radeon RX |
| Professionele lijn | RTX PRO | Radeon PRO |
| Datacenterlijn | H100/H200, Blackwell, Rubin | Instinct MI300-, MI350- en MI400-series |
| Groot voordeel | Volwassen ecosysteem en brede compatibiliteit | Sterke hardware, veel geheugen in bepaalde producten en open stack |
| Grootste aandachtspunt | Kosten en leveranciersafhankelijkheid | Ondersteuning verschilt sterker per GPU, OS en framework |
| Beste voor | Teams die brede, bewezen softwareondersteuning prioriteren | Teams die compatibiliteit vooraf testen en prijs/geheugen willen optimaliseren |
Dit is een algemene samenvatting. Binnen beide merken verschillen productgeneraties en uitvoeringen sterk.
Hardware is maar de helft van de vergelijking
AI-berekeningen draaien niet rechtstreeks op een specificatietabel. Een model gebruikt een framework, kernels, libraries, drivers, een modelserver en soms communicatie tussen meerdere GPU’s. Wanneer één laag ontbreekt of slecht is geoptimaliseerd, blijft een groot deel van de theoretische prestatie liggen.
Daarom moet een vergelijking minimaal vier niveaus omvatten:
- chip: rekenformaten, geheugen, bandbreedte en energie;
- systeem: CPU, interconnect, netwerk, koeling en opslag;
- software: frameworks, kernels, containers en beheertools;
- organisatie: kennis, support, beschikbaarheid en migratiekosten.
CUDA versus ROCm
CUDA
CUDA is Nvidia’s platform voor accelerated computing. Het bestaat sinds 2006 en omvat een programmeermodel, Toolkit, drivers en geoptimaliseerde libraries. Veel AI-projecten worden eerst op CUDA ontwikkeld en getest.
Dat levert praktische voordelen op:
- brede ondersteuning in PyTorch en andere frameworks;
- veel voorgebouwde containers en tutorials;
- libraries zoals cuDNN, NCCL en TensorRT-LLM;
- ruime beschikbaarheid van ervaren ontwikkelaars;
- snelle ondersteuning voor nieuwe Nvidia-producten.
Het nadeel is lock-in: rechtstreeks geschreven CUDA-code draait niet op AMD-hardware.
ROCm
ROCm is AMD’s open-source softwareplatform voor GPU-computing. Het bevat drivers, compilers, libraries en hulpmiddelen voor AI en high-performance computing. HIP biedt een C++-omgeving die op CUDA lijkt en helpt bestaande code over te zetten.
ROCm is de afgelopen generaties sterk verbeterd. Toch is “ROCm ondersteunt PyTorch” niet voldoende als aankoopcriterium. Ondersteuning hangt af van:
- het exacte AMD-GPU-model;
- Linux-distributie of Windows-versie;
- ROCm-versie;
- frameworkbuild;
- gebruikte operatoren en extensies;
- multi-GPU- en virtualisatie-eisen.
Controleer daarom altijd AMD’s actuele compatibility matrix. Een oudere Radeon-kaart kan technisch krachtig zijn maar buiten de officieel ondersteunde combinatie vallen.
Kan CUDA-code op AMD draaien?
Niet rechtstreeks. Er zijn drie routes:
- Frameworkniveau: code gebruikt alleen algemene PyTorch- of JAX-operaties. Dan kan een andere backend relatief eenvoudig zijn.
- HIP-port: CUDA-achtige C++-code wordt met HIPIFY-tools en handmatige aanpassingen naar HIP overgezet.
- Herschrijven of vervangen: een Nvidia-specifieke library wordt vervangen door een ROCm-equivalent of een eigen implementatie.
De moeilijkheid zit vaak niet in één kernel, maar in het geheel: buildsystemen, containers, monitoring, deployment en kennis van het team. Maak vóór een migratie een inventaris van alle CUDA-afhankelijkheden.
Consumenten-GPU’s: GeForce versus Radeon
Voor lokale taalmodellen en beeldgeneratie is VRAM vaak de eerste grens. Beide merken bieden kaarten met interessante prijs-prestatieverhoudingen, maar softwareondersteuning verschilt per applicatie.
Waarom GeForce vaak eenvoudiger is
Veel lokale AI-tools bieden een Nvidia/CUDA-route als eerste. Documentatie, communityoplossingen en kant-en-klare Windows-builds zijn ruim beschikbaar. Wie zonder veel configuratie Stable Diffusion, PyTorch-extensies of verschillende modelservers wil proberen, heeft vaak minder frictie.
Wanneer Radeon interessant is
Een Radeon-kaart kan aantrekkelijk zijn wanneer:
- het gewenste model en programma officieel worden ondersteund;
- een kaart meer geheugen biedt binnen het budget;
- Linux acceptabel is;
- de gebruiker bereid is compatibiliteit vooraf te testen;
- gamingprestatie naast AI belangrijk is.
Koop geen consumenten-GPU op basis van merk alleen. Kies eerst de applicaties en controleer hun actuele ondersteunde backends.
De concrete Nvidia-opties staan in onze koopgids voor een Nvidia-GPU voor lokale AI.
Datacenters: Nvidia tegenover AMD Instinct
Nvidia’s datacenterlijn loopt van Hopper-producten zoals H100 en H200 via Blackwell en Blackwell Ultra naar Rubin. AMD ontwikkelt Instinct-accelerators en complete rackontwerpen.
AMD lanceerde MI455X op 23 juli 2026 binnen de MI400-serie. AMD vermeldt 432 GB HBM4 en 23,3 TB per seconde geheugenbandbreedte. Helios is AMD’s open rack-scale referentieontwerp met 72 MI455X-GPU’s, 18 EPYC-processors en 31 TB gezamenlijk HBM4. AMD lanceerde de eerste Helios-oplossingen op 23 juli 2026 en meldde dat deze in productie zijn. De systemen worden via OEM- en infrastructuurpartners geleverd; productie betekent daarom niet dat iedere configuratie direct in iedere regio te bestellen is.
Nvidia biedt eveneens systemen met 72 gekoppelde GPU’s, zoals GB300 NVL72 en de Rubin-generatie. Onze gids over Nvidia’s H100, H200, Blackwell en Rubin legt de verschillende productlagen uit.
Een vergelijking “72 versus 72” is nog niet compleet. Let ook op:
- totaal snel geheugen;
- bandbreedte binnen en buiten het rack;
- ondersteunde precisie;
- stroom- en koelvereisten;
- modelserver en communicatielibraries;
- gemeten latency en throughput;
- leverdatum en supportcontract.
Prestaties: waarom leveranciersbenchmarks voorzichtig moeten worden gelezen
Nvidia en AMD publiceren allebei cijfers waarin de eigen nieuwste generatie sterk presteert. Zulke claims kunnen technisch correct zijn binnen de gekozen opstelling, maar zijn niet automatisch toepasbaar op een andere workload.
Controleer:
- wordt één chip of een compleet rack gemeten?
- gaat het om training, batch-inference of interactieve inference?
- welk model en welke contextlengte zijn gebruikt?
- is quantisatie toegepast?
- wordt sparsity meegeteld?
- is software voor één platform verder geoptimaliseerd?
- gaat het om tokens per seconde, latency, energie of kosten?
Onafhankelijke benchmarkreeksen zoals MLPerf helpen, maar ook daar moeten systeemgrootte en scenario overeenkomen. De beste test blijft een representatieve eigen workload.
Geheugen kan belangrijker zijn dan piekrekenkracht
Een groot model dat op minder GPU’s past, heeft minder communicatie nodig. Daardoor kan een accelerator met meer geheugen ondanks een lagere theoretische piek sneller of goedkoper uitvallen.
Let op drie eigenschappen:
- capaciteit: hoeveel model, cache en batch past;
- bandbreedte: hoe snel gewichten en activaties worden gelezen;
- topologie: hoe snel meerdere GPU’s gegevens uitwisselen.
AMD zet bij bepaalde Instinct-generaties nadrukkelijk in op veel HBM-geheugen. Nvidia combineert geheugen met een volwassen NVLink- en softwarestack. Welke combinatie wint, hangt af van modelgrootte en serveerpatroon.
Multi-GPU en netwerken
Voor training en grote inference worden workloads verdeeld. Nvidia gebruikt onder meer NCCL voor communicatie en NVLink/NVSwitch voor scale-up. AMD heeft RCCL en Infinity Fabric.
De rekenchips communiceren daarnaast tussen servers via InfiniBand of Ethernet. Nvidia bezit zowel compute- als belangrijke netwerktechnologie, wat integratie kan vereenvoudigen. AMD werkt met een breder ecosysteem van netwerk- en systeempartners.
Vraag bij een clusterontwerp naar de gemeten collectieve communicatie, niet alleen de poortsnelheid op papier.
Cloudbeschikbaarheid
Cloudproviders bieden verschillende acceleratorfamilies, maar regio, quota en prijsmodel verschillen. Nvidia-capaciteit is doorgaans breed beschikbaar. AMD Instinct is bij meerdere grote providers beschikbaar of aangekondigd, maar de keuze per regio kan beperkter zijn.
Cloud kan een goede manier zijn om te testen:
- maak een representatieve container;
- draai dezelfde dataset en modelversie;
- meet cold start, latency, throughput en fouten;
- bereken kosten bij verwachte bezettingsgraad;
- test operationele zaken zoals monitoring en autoscaling.
Een uurtarief zegt weinig zonder benutting. Een duurdere instance kan per taak goedkoper zijn als hij sneller klaar is; een gekochte server kan duur zijn wanneer hij grotendeels stil staat.
Support, beveiliging en lifecycle
Voor productie tellen voorspelbare updates en support. Nvidia koppelt veel enterprisecomponenten aan Nvidia AI Enterprise en NIM. AMD biedt enterpriseondersteuning via hardware-, software- en systeempartners.
Beoordeel:
- hoe lang een driver- en OS-combinatie wordt ondersteund;
- wie verantwoordelijk is bij een fout tussen hardware en framework;
- hoe beveiligingsupdates worden geleverd;
- of virtualisatie en Kubernetes zijn gevalideerd;
- welke responstijd in het supportcontract staat;
- of onderdelen tijdens de levensduur vervangbaar zijn.
Een open-source stack voorkomt niet vanzelf operationele kosten. Een commerciële stack voorkomt niet vanzelf storingen.
Totale kosten: kijk verder dan de aankoopprijs
Total cost of ownership omvat:
- hardware of clouduren;
- stroom en koeling;
- netwerk en opslag;
- rackruimte;
- softwarelicenties;
- engineeringtijd;
- migratie en hertesten;
- uitval en support;
- restwaarde;
- bezettingsgraad.
Stel dat AMD-hardware goedkoper is, maar een team maanden nodig heeft om eigen CUDA-extensies over te zetten. Dan kan Nvidia over de projectduur goedkoper blijven. Andersom kan een organisatie met portable frameworkcode en voldoende ROCm-kennis veel besparen door concurrentie tussen leveranciers.
Beslismatrix
| Vraag | Nvidia ligt voor de hand als… | AMD ligt voor de hand als… |
| Software | veel CUDA-specifieke code of libraries nodig zijn | de stack aantoonbaar op ROCm werkt |
| Snel starten | minimale integratiefrictie prioriteit heeft | tijd beschikbaar is voor validatie |
| Geheugen | Nvidia-configuratie voldoende en gevalideerd is | een AMD-product aantoonbaar meer passend geheugen biedt |
| Leverancier | één geïntegreerd platform gewenst is | onderhandelingsruimte en open componenten zwaarder wegen |
| Team | veel CUDA-ervaring aanwezig is | ROCm/HIP-ervaring aanwezig is |
| Migratie | huidige Nvidia-stack bedrijfskritisch is | code grotendeels backend-onafhankelijk is |
| Cloud | gewenste Nvidia-instance direct beschikbaar is | AMD-instance in de gewenste regio een beter gemeten kostenprofiel heeft |
Een veilige selectiemethode
- Definieer modellen, precisie, context, batch en servicelevel.
- Maak een lijst van alle softwareafhankelijkheden.
- Controleer officiële supportmatrices.
- Benchmark minimaal één Nvidia- en één AMD-configuratie.
- Meet zowel prestaties als engineeringfrictie.
- Bereken kosten over drie scenario’s voor bezettingsgraad.
- Test storingsherstel, monitoring en updates.
- Leg een migratie- of exitstrategie vast.
Zo voorkom je dat een keuze wordt gebaseerd op een losse productpresentatie.
Lees ook

Conclusie: kies de stack, niet het logo
Nvidia biedt de meest gevestigde combinatie van hardware, CUDA, libraries, systemen en enterpriseondersteuning. Dat maakt het vaak de veiligste keuze wanneer compatibiliteit en snelle uitvoering belangrijker zijn dan de laagste aanschafprijs.
AMD kan een sterk alternatief zijn wanneer het gewenste model officieel op ROCm werkt, geheugencapaciteit of prijs gunstig uitvalt en het team de stack kan valideren. Meer concurrentie is bovendien waardevol voor beschikbaarheid en onderhandeling.
De winnaar volgt uiteindelijk uit de eigen workload. Benchmark dezelfde modellen, tel software- en migratiekosten mee en kies pas daarna.
Veelgestelde vragen over Nvidia versus AMD voor AI
Is Nvidia altijd sneller dan AMD voor AI?
Nee. Het resultaat hangt af van GPU, model, precisie, software en systeemgrootte. Nvidia heeft vaak een compatibiliteitsvoordeel; AMD kan bij specifieke workloads en geheugenbehoeften beter uitvallen.
Kan PyTorch op AMD draaien?
Ja, via ROCm op ondersteunde hardware- en softwarecombinaties. Controleer de actuele AMD- en PyTorch-documentatie voor het exacte GPU-model en besturingssysteem.
Werkt CUDA op AMD?
Nee. CUDA is voor Nvidia-GPU’s. CUDA-code kan soms met HIP worden geporteerd, maar compatibiliteit en benodigde aanpassingen verschillen.
Is AMD beter voor grote taalmodellen door meer geheugen?
Sommige AMD-accelerators bieden veel HBM-geheugen. Of dat een voordeel oplevert, hangt ook af van bandbreedte, modelserver, communicatie, softwareondersteuning en prijs.
Welke GPU is beter voor Stable Diffusion?
Dat hangt af van de gebruikte interface en extensies. Nvidia is vaak eenvoudiger door brede CUDA-ondersteuning. Een AMD-GPU kan goed werken wanneer de gekozen software en het besturingssysteem officieel worden ondersteund.
Moet een bedrijf voor één leverancier kiezen?
Niet per se. Een organisatie kan verschillende backends gebruiken of een tweede leverancier kwalificeren. Dat verlaagt leveringsrisico, maar vergroot test- en beheercomplexiteit.
Robin HeesterOprichter
Robin Heester is mede-oprichter van AI Wereld en heeft door de jaren heen meerdere websites, nieuwsbrieven en magazines opgericht. Hij schrijft over technologie, innovatie en de maatschappelijke impact van nieuwe digitale ontwikkelingen.
Populair nieuws
Laatste reacties
- Is volgens X zelf aan de hand https://x.com/GlobalAffairs/status/2093130747796148634RobinHeester29-08-2026
- Wapeniseert?? Dit is een erg onbetrouwbaar bericht. Niet alleen slecht vertaald, maar ook niet controleerbaar.Cas.v28-08-2026
- Niet mijn observatie dat de toeleveringsaanvoer stabiliseert.Cas.v26-08-2026
- Ja, de transcriptie van het gesprek is gedaan met AI. Dank voor de feedback over de herhalingen, daar kan ik zeker nog wat scherper op zijn.RobinHeester21-08-2026
- Goed artikel, alleen jammer dat er zoveel Ai bij gebruikt is om het te schrijven, veel herhalingen, het had een stuk compacter gekund.🙃Cas.v21-08-2026
- Voor zover ik weet moet je bij academische publicaties vooral eerlijk en transparant zijn over hoe en waar je AI hebt gebruikt. En de oorspronkelijke informatiebronnen kunnen dan gewoon volgens APA worden vermeld. Maar daar weet ik het fijne ook (nog) niet van.RobinHeester13-08-2026
- Ik ben benieuwd wat dit gaat betekenen voor de APA verwijzingen in academische publicaties.Cas.v13-08-2026
- Wie wordt er beter van.....zal Meta wel zijnhenk.h10-07-2026
- Wat voor weer wordt het vandaaghenk.h03-07-2026
- Dit artikel is van 1 april, dus deze belasting is niet echt. Gelukkig maar. :)RobinHeester12-05-2026
Loading