Wat is Nvidia? Complete uitleg over het bedrijf, AI-chips, GPU’s en CUDA
Blogwoensdag, 26 augustus 2026 om 5:00
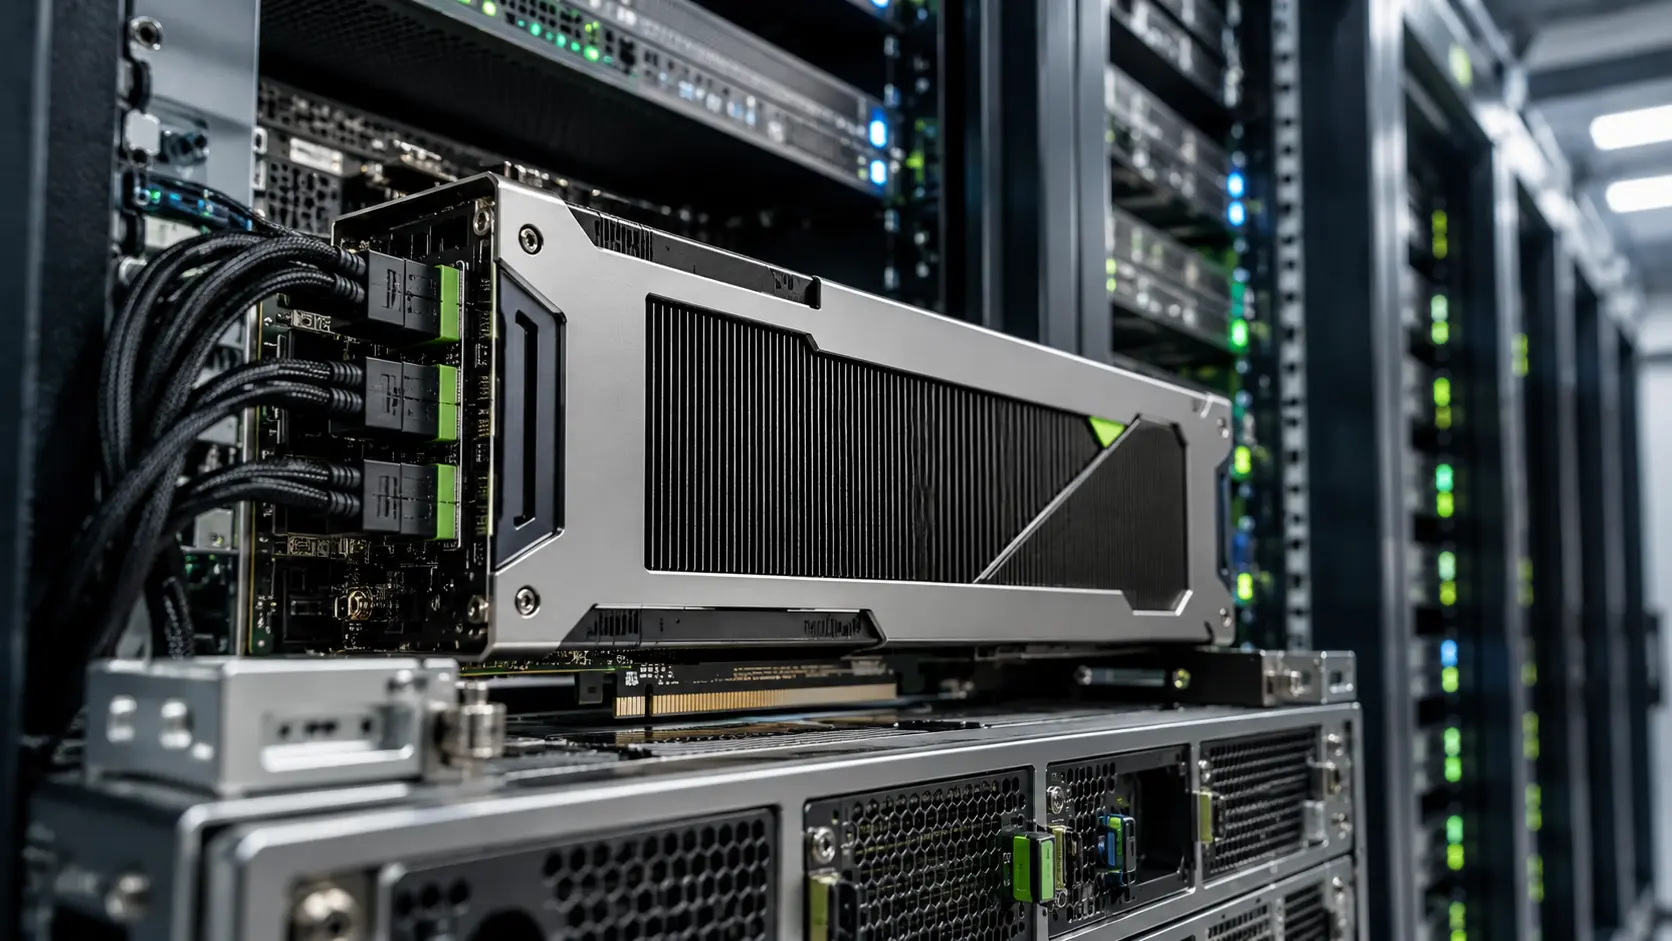
Nvidia is een Amerikaans technologiebedrijf dat processors, netwerktechnologie, software en complete computersystemen ontwikkelt. Het bedrijf werd groot met grafische chips voor computerspellen, maar speelt inmiddels een centrale rol in kunstmatige intelligentie. Veel AI-modellen worden getraind en uitgevoerd op Nvidia-GPU’s, met software die rond het programmeerplatform CUDA is gebouwd.
Nvidia is dus niet simpelweg “een chipmaker”. Het bedrijf verkoopt een samenhangend platform: rekenchips, verbindingen tussen die chips, servers, softwarebibliotheken, vooraf gebouwde AI-diensten en ondersteuning voor bedrijven. Juist die combinatie verklaart waarom Nvidia zo belangrijk werd voor generatieve AI, datacenters, robotica en wetenschappelijk rekenen.
Nvidia in het kort
| Onderdeel | Uitleg |
| Volledige naam | NVIDIA Corporation |
| Opgericht | 1993 |
| Oprichters | Jensen Huang, Chris Malachowsky en Curtis Priem |
| Hoofdkantoor | Santa Clara, Californië |
| Bekend van | GeForce, CUDA, Blackwell, Vera Rubin, DGX, RTX Spark, Agent Toolkit en Omniverse |
| Belangrijkste markten | Datacenters, gaming, professionele visualisatie en automotive |
| Bedrijfsmodel | Ontwerp van chips en systemen, aangevuld met software en diensten |
| Productie | Nvidia ontwerpt zijn chips en laat de fabricage grotendeels uitvoeren door gespecialiseerde partners |
Wat doet Nvidia precies?
Nvidia ontwerpt technologie waarmee computers grote hoeveelheden berekeningen parallel kunnen uitvoeren. De bekendste producten zijn graphics processing units, meestal afgekort tot GPU’s. Die processors ontstonden voor 3D-graphics, maar blijken ook zeer geschikt voor de matrixberekeningen achter neurale netwerken.
Daarom komt Nvidia tegenwoordig in verschillende lagen van de computerinfrastructuur terug:
- Chips: GPU’s voor gaming, werkstations en datacenters, maar ook CPU’s, netwerkprocessors en andere accelerators.
- Verbindingen: NVLink, InfiniBand en Ethernet-oplossingen waarmee grote aantallen chips gegevens uitwisselen.
- Systemen: kant-en-klare machines en racks, waaronder DGX-systemen en platforms rond Grace Blackwell.
- Software: CUDA, versnelde bibliotheken, AI-frameworks en beheersoftware.
- Modellen en agentsoftware: onder meer Nemotron, NIM-microservices, NeMo, Agent Toolkit, OpenShell en zakelijke ondersteuning via AI Enterprise.
- Simulatie: Omniverse-technologie voor 3D-samenwerking, industriële digital twins, synthetische data en robotica.
Die lagen versterken elkaar. Een klant koopt niet alleen een snelle processor, maar kan ook gebruikmaken van drivers, ontwikkeltools, geoptimaliseerde libraries, referentiearchitecturen en commerciële ondersteuning. Dat verlaagt de drempel om een AI-systeem te bouwen, maar kan een organisatie ook sterk afhankelijk maken van één leverancier.
Van 3D-graphics naar AI-infrastructuur
Nvidia werd op 5 april 1993 opgericht door Jensen Huang, Chris Malachowsky en Curtis Priem. De eerste focus lag op chips voor computergraphics. In de jaren negentig werd 3D-weergave steeds belangrijker voor games en professionele toepassingen. Daarvoor waren processors nodig die veel vergelijkbare berekeningen tegelijk konden uitvoeren.
In 1999 introduceerde Nvidia de GeForce 256 en gebruikte het bedrijf de term GPU nadrukkelijk voor een processor die een groot deel van de grafische verwerking zelfstandig uitvoerde. Het commerciële succes in gaming leverde schaal, ontwikkelkennis en een grote gebruikersbasis op.
De beslissende verbreding volgde in 2006 met CUDA. Dit platform maakte het voor programmeurs mogelijk om Nvidia-GPU’s voor algemene berekeningen in te zetten, dus niet alleen voor pixels en 3D-objecten. Wetenschappers gebruikten GPU’s vervolgens voor simulaties, beeldanalyse en andere rekentaken. Wie precies wil begrijpen hoe die softwarelaag werkt, leest de aparte uitleg over CUDA en het Nvidia-ecosysteem.
In 2012 liet AlexNet zien hoe goed GPU’s pasten bij deep learning. Het neurale netwerk werd op twee Nvidia GTX 580-kaarten getraind en presteerde overtuigend in de ImageNet-competitie. Dat moment was niet de uitvinding van AI of deep learning, maar wel een belangrijk bewijs dat GPU-versnelling grotere neurale netwerken praktisch uitvoerbaar maakte. De bredere ontwikkeling staat in onze geschiedenis van kunstmatige intelligentie.
De komst van generatieve AI versnelde deze ontwikkeling opnieuw. Grote taalmodellen vereisen enorme hoeveelheden rekenwerk tijdens zowel training als gebruik. Modelbedrijven zoals OpenAI en hun infrastructuurpartners plannen daarom niet alleen losse GPU’s, maar complete clusters met snelle netwerken, veel geheugen, koeling en gespecialiseerde software.
Waarom zijn Nvidia-GPU’s belangrijk voor AI?
Een neuraal netwerk voert grote aantallen vermenigvuldigingen en optellingen uit. Veel daarvan kunnen tegelijk plaatsvinden. Een CPU heeft relatief weinig krachtige cores die uiteenlopende taken snel afhandelen. Een GPU bevat veel meer rekeneenheden die hetzelfde type bewerking parallel kunnen uitvoeren.
Dat betekent niet dat een GPU altijd beter is dan een CPU. Besturingslogica, databases, voorbereiding van data en seriële taken blijven vaak bij de CPU. Voor de zwaarste matrixbewerkingen van training en inference is een GPU echter meestal veel efficiënter.
Ook geheugen is belangrijk. Een model, de tijdelijke tussenresultaten en bij training ook optimizerdata moeten zo dicht mogelijk bij de rekenchip beschikbaar zijn. Daarom draait AI-prestatie niet alleen om een hoog aantal FLOPS. Geheugencapaciteit, geheugenbandbreedte, precisie, netwerkverbindingen, software-optimalisatie en energieverbruik tellen allemaal mee.
In onze uitgebreide uitleg over GPU’s voor AI behandelen we dit architectuurverschil, inclusief training, inference, VRAM en geheugenbandbreedte.
Wat is CUDA en waarom is het een voordeel?
CUDA is Nvidia’s platform voor accelerated computing. Het bestaat niet uit één programma, maar uit een combinatie van een programmeermodel, compiler, runtime, ontwikkeltools en gespecialiseerde libraries. Ontwikkelaars kunnen er code mee uitvoeren op Nvidia-GPU’s.
Veel gebruikers schrijven niet rechtstreeks CUDA-code. Frameworks zoals PyTorch gebruiken CUDA en geoptimaliseerde Nvidia-libraries onder de motorkap. Daardoor kan een onderzoeker een model trainen zonder zelf een GPU-kernel te programmeren.
Het grote voordeel is de volwassenheid van het ecosysteem. Er zijn hulpmiddelen voor lineaire algebra, deep learning, data-analyse, simulatie en vele andere workloads. Hardware en software worden samen ontwikkeld, waardoor nieuwe functies relatief snel door frameworks kunnen worden benut.
De keerzijde is afhankelijkheid. CUDA werkt op Nvidia-hardware. Een organisatie die veel eigen CUDA-code, geoptimaliseerde libraries en beheerprocessen heeft opgebouwd, kan niet zonder werk naar een ander platform overstappen. In de vergelijking Nvidia versus AMD voor AI staat daarom niet alleen snelheid centraal, maar ook compatibiliteit en migratiekosten.
Welke AI-chips maakt Nvidia?
Nvidia gebruikt verschillende productnamen voor chips, modules, complete systemen en rackoplossingen. Daardoor lijken vergelijkingen eenvoudiger dan ze zijn. Een H100 is bijvoorbeeld een datacenter-GPU op basis van de Hopper-architectuur. Een H200 gebruikt eveneens Hopper, maar combineert die architectuur met meer en sneller geheugen. Blackwell is een nieuwere architectuur, terwijl GB200 verwijst naar een Grace Blackwell Superchip die GPU’s en een Arm-gebaseerde Grace-CPU combineert.
De belangrijkste generaties van de afgelopen jaren zijn:
- H100: Hopper-GPU die op grote schaal werd gebruikt voor AI-training en inference.
- H200: Hopper-variant met 141 GB HBM3e-geheugen en hogere geheugenbandbreedte.
- B200 en GB200: Blackwell-producten voor grotere modellen en sterk gekoppelde systemen.
- B300 en GB300: Blackwell Ultra, met meer geheugen en capaciteit voor onder meer reasoning-workloads.
- Vera Rubin: platform rond Rubin-GPU’s, Vera-CPU’s, NVLink 6, BlueField-4, Spectrum-6 en andere componenten. Nvidia schaalde de productie in 2026 op; concrete systemen en cloudinstances worden gefaseerd vanaf de tweede helft van 2026 geleverd.
- Groq 3 LPX: gespecialiseerde inferenceversnelling die Nvidia naast Rubin in het bredere rackplatform positioneert. Groq 3 LPX ging volgens Nvidia op 24 augustus 2026 in volledige productie.
Nvidia verkoopt deze technologie op meerdere schaalniveaus: als chip of module aan systeemfabrikanten, als DGX-systeem en als geïntegreerde rackarchitectuur. Onze gids over H100, H200, Blackwell en Rubin zet de naamgeving, specificaties en verschillen naast elkaar.
Wat is Nvidia DGX?
DGX is Nvidia’s lijn van geïntegreerde AI-computers en infrastructuur. Het idee is dat processor, netwerk, opslagkoppeling, software en ondersteuning als één gevalideerd geheel worden geleverd. Dat is iets anders dan zelf een server samenstellen met losse videokaarten.
Aan de compacte kant staat DGX Spark: een leverbare Linux-computer met een Grace Blackwell GB10-superchip en 128 GB coherent unified memory. Het systeem is bedoeld voor lokale ontwikkeling, prototyping en agents op een bureau. DGX Station is een veel zwaardere deskside computer met een GB300 Grace Blackwell Ultra Desktop Superchip en 748 GB coherent memory. Aan de andere kant van het spectrum staan rackservers en SuperPOD-omgevingen voor datacenters.
RTX Spark is geen DGX Spark. RTX Spark is een afzonderlijk superchipplatform voor Windows-laptops en compacte pc’s, met maximaal 128 GB unified memory. Nvidia en Microsoft kondigden de eerste systemen voor het najaar van 2026 aan; op de peildatum waren ze nog niet algemeen leverbaar. De verschillen staan in onze aparte uitleg over Nvidia RTX Spark voor lokale AI en agents.
Een DGX-oplossing is niet automatisch de voordeligste keuze. Organisaties betalen ook voor integratie, validatie, beheer en ondersteuning. De aparte gids Nvidia DGX en DGX Spark uitgelegd helpt bepalen wanneer dat voordeel opweegt tegen een eigen werkstation, cloud-GPU of maatwerkcluster.
Nvidia voor lokale AI
Ook thuis of op kantoor kan een Nvidia-GPU lokale AI versnellen. Dat kan aantrekkelijk zijn voor privacy, lagere wachttijd, experimenten zonder verbruikskosten en werken zonder permanente internetverbinding. De bepalende eigenschap is vaak niet de theoretische topsnelheid, maar de hoeveelheid beschikbaar videogeheugen.
Een klein, gequantiseerd taalmodel kan op een kaart met 8 of 12 GB VRAM passen. Grotere modellen, langere contextvensters, beeldgeneratie en finetuning vragen meer. Een 16GB-kaart is daardoor flexibeler dan een 8GB-model, terwijl 24 of 32 GB nieuwe mogelijkheden opent. Voor professionele workloads zijn er kaarten met nog veel meer geheugen.
Onze praktische koopgids voor een Nvidia-GPU voor lokale AI koppelt modelgrootte en workload aan VRAM-klassen. Voor het daadwerkelijk draaien van een model zijn er aparte stappenplannen, zoals DeepSeek lokaal installeren met Ollama en LM Studio.
Een losse GeForce-kaart, DGX Spark en RTX Spark lossen niet hetzelfde probleem op. GeForce is flexibel voor een zelfgebouwde pc; DGX Spark is een compacte Linux-ontwikkelmachine; RTX Spark richt zich op geïntegreerde Windows-systemen en persoonlijke agents. Kijk daarom niet alleen naar het geheugencijfer, maar ook naar besturingssysteem, processorarchitectuur, uitbreidbaarheid, softwarecompatibiliteit en leverstatus.
Nvidia Agent Toolkit, AI Enterprise, NIM en NeMo
Voor bedrijven is een werkend experiment pas het begin. Een productieomgeving moet worden beveiligd, gemonitord, bijgewerkt en ondersteund. Nvidia bouwde daarom een commerciële softwarelaag rond zijn hardware.
Nvidia AI Enterprise is een software- en supportaanbod voor productie-AI. Het omvat gevalideerde componenten, ondersteuning en een lifecycle die beter past bij bedrijfssystemen dan losse experimentele pakketten.
Nvidia NIM bestaat uit geoptimaliseerde inference-microservices. Een NIM verpakt een model met een geschikte inference-engine en afhankelijkheden in een container met gestandaardiseerde API’s. Dat kan de stap van model naar dienst verkorten.
Nvidia NeMo richt zich op het bouwen, aanpassen, evalueren en beheren van generatieve AI en agents. NIM en NeMo zijn dus geen synoniemen: NeMo helpt bij de ontwikkel- en optimalisatiefase; NIM is vooral een leveringsvorm voor inference.
Nvidia Agent Toolkit is in 2026 de bredere paraplu voor agentsoftware. De stack combineert onder meer open Nemotron-modellen, agentblueprints, aanroepbare CUDA-X- en Omniverse-tools en OpenShell als geïsoleerde runtime. NemoClaw is een open referentiestack voor OpenClaw, maar de repository noemt die uitvoering nog alpha en niet productierijp. Nvidia gebruikt de term daarnaast voor het kleinere NeMo Agent Toolkit, een framework-onafhankelijke Python-library die eerder AgentIQ heette. Controleer daarom altijd welk product met “Agent Toolkit” wordt bedoeld.
Deze laag verbindt Nvidia direct met AI-agents: systemen die modellen combineren met tools, gegevensbronnen en acties. Lokale uitvoering kan privacy en voorspelbare kosten bieden, maar een agent met brede bestands-, netwerk- of accountrechten blijft een beveiligingsrisico. De algemene infrastructuurafweging wordt behandeld in grip op AI-agents begint bij grip op infrastructuur.
In de complete gids over Nvidia Agent Toolkit, NIM, NeMo, Nemotron en OpenShell staan architectuur, licenties, agentbeveiliging en de afweging tussen lokaal, eigen datacenter en cloud centraal. Voor de bredere cloudcontext is ook onze uitleg over Microsoft Azure relevant.
Omniverse, digital twins en physical AI
Nvidia wil niet alleen de infrastructuur leveren waarop taalmodellen draaien. Met Omniverse richt het bedrijf zich op 3D-toepassingen, industriële simulaties, digital twins en robotica. De technologie is gebouwd rond OpenUSD, een open raamwerk voor het beschrijven en uitwisselen van complexe 3D-werelden.
Een fabrikant kan bijvoorbeeld een digitale representatie van een fabriek gebruiken om logistiek, veiligheid of robotgedrag te testen voordat een fysieke installatie wordt aangepast. Synthetische beelden uit simulaties kunnen bovendien trainingsdata opleveren voor camerasystemen en robots.
Omniverse is tegenwoordig beter te begrijpen als een verzameling ontwikkeltechnologieën, libraries en microservices dan als één eindgebruikersprogramma. De vroegere Omniverse Launcher en lokale Nucleus Workstation-route zijn uitgefaseerd; de onderliggende ontwikkelplatformen blijven bestaan. In juli 2026 voegde Nvidia bovendien agent-callable Omniverse-libraries toe, zodat softwareagents onder gecontroleerde voorwaarden simulatie-, physics- en assetworkflows kunnen aanroepen. De volledige context staat in onze uitleg over Nvidia Omniverse en physical AI.
Waar verdient Nvidia zijn geld mee?
Nvidia rapporteert vier belangrijke eindmarkten: Data Center, Gaming, Professional Visualization en Automotive. Data Center is door de AI-golf veruit de grootste geworden. In boekjaar 2026 rapporteerde Nvidia een totale omzet van 215,9 miljard dollar; het overgrote deel hing samen met compute- en netwerkproducten. In het eerste kwartaal van boekjaar 2027 bedroeg de omzet 81,6 miljard dollar, waarvan 75,2 miljard uit Data Center kwam.
Deze cijfers zijn een momentopname en geen garantie voor toekomstige groei. Ze laten wel zien dat Nvidia’s economische zwaartepunt is verschoven. Gaming blijft belangrijk voor het merk en voor consumentenproducten, maar datacenterinfrastructuur bepaalt inmiddels het grootste deel van de omzet.
Nvidia is een zogenoemd fabless chipbedrijf. Het ontwerpt chips en systemen, maar bezit niet zelf alle fabrieken waarin de meest geavanceerde halfgeleiders worden gemaakt. Productie en verpakking zijn afhankelijk van partners, waaronder TSMC en Samsung. Dat maakt de onderneming schaalbaar, maar creëert ook afhankelijkheid van een beperkt aantal leveranciers en geopolitiek gevoelige productieketens.
Waarom is Nvidia moeilijk te vervangen?
De positie van Nvidia berust op meer dan de snelheid van één chip.
1. Een grote geïnstalleerde basis
Onderzoekers, universiteiten, cloudproviders en bedrijven gebruiken Nvidia-hardware al jaren. Kennis, scripts en processen zijn daarop afgestemd.
2. Het CUDA-ecosysteem
Veel AI-software ondersteunt Nvidia als eerste of is er het uitgebreidst voor getest. Dat verschil wordt kleiner naarmate alternatieven verbeteren, maar compatibiliteit blijft een praktisch criterium.
3. Hardware en software uit één hand
Nvidia optimaliseert chips, interconnects, libraries en systemen gezamenlijk. Daardoor kan een verbetering op één laag doorwerken in de rest van het platform.
4. Netwerken op clusterschaal
Bij duizenden accelerators is communicatie vaak net zo belangrijk als de snelheid van één GPU. Nvidia bezit na de overname van Mellanox belangrijke InfiniBand- en Ethernettechnologie en ontwikkelt NVLink voor directe GPU-verbindingen.
5. Een jaarlijks ontwikkelritme
Nvidia probeert regelmatig nieuwe architecturen, systemen en software uit te brengen. Klanten krijgen daardoor snel meer capaciteit, maar moeten ook omgaan met korte productcycli en complexe migratieplanning.
Welke concurrenten heeft Nvidia?
Nvidia concurreert op verschillende fronten:
- AMD verkoopt Instinct-accelerators, waaronder MI355X en MI455X, ontwikkelt ROCm als open softwareplatform en positioneert Helios als rack-scale alternatief.
- Google gebruikt eigen TPU’s voor interne diensten en Google Cloud.
- Amazon Web Services ontwikkelt Trainium en Inferentia.
- Microsoft en andere cloudbedrijven ontwerpen eigen AI-chips voor specifieke workloads.
- Intel en gespecialiseerde chipbedrijven richten zich op accelerators, inference of netwerken.
- Grote afnemers ontwerpen steeds vaker eigen silicium om kosten, energiegebruik en leveringsrisico’s te beheersen.
Een alternatief hoeft Nvidia niet op ieder onderdeel te verslaan. Een cloudprovider kan een eigen accelerator goedkoper inzetten voor een sterk afgebakende workload, terwijl Nvidia aantrekkelijk blijft voor teams die maximale softwarecompatibiliteit willen. De keuze gaat daarom om de volledige workload en niet om één benchmark.
Wat zijn de belangrijkste risico’s en kritiekpunten?
Hoge kosten
Geavanceerde AI-systemen zijn duur in aanschaf en gebruik. Naast de chips tellen stroom, koeling, netwerk, opslag, personeel en software mee. De werkelijke total cost of ownership kan sterk afwijken van de aankoopprijs.
Energie- en watergebruik
Grotere AI-clusters vragen veel elektriciteit en geavanceerde koeling. Nieuwere chips kunnen per berekening efficiënter zijn, maar een snelle groei van het totale gebruik kan die winst overtreffen. Lees voor die infrastructuurkant onze uitleg over AI-datacenters en hun impact.
Leveringsketen
Nvidia is afhankelijk van geavanceerde chipfabricage, geheugen, verpakking en systeempartners. Tekorten of geopolitieke spanningen kunnen leveringen beïnvloeden.
Exportregels
Krachtige AI-chips vallen onder veranderende handels- en exportbeperkingen. Producten kunnen per land verschillen en regels kunnen omzet, productontwerp en beschikbaarheid raken.
Platformafhankelijkheid
Een team dat diep op CUDA en Nvidia-specifieke diensten leunt, bouwt overstapkosten op. Open standaarden, overdraagbare containers en periodieke tests op alternatieve hardware kunnen dit risico verkleinen.
Hype en onvergelijkbare benchmarks
Fabrikanten publiceren vaak prestaties onder gunstige instellingen. Resultaten hangen af van model, batchgrootte, numerieke precisie, softwareversie, stroomlimiet en clustergrootte. Een claim als “x keer sneller” is daarom pas bruikbaar wanneer de testopstelling en de eigen workload overeenkomen.
Wie is Jensen Huang?
Jensen Huang is medeoprichter, president en CEO van Nvidia en leidt het bedrijf sinds 1993. Zijn lange ambtstermijn is uitzonderlijk voor een beursgenoteerd technologiebedrijf. Onder zijn leiding verschoof Nvidia van pc-graphics naar programmeerbare GPU’s, AI-infrastructuur en complete datacentersystemen.
Die ontwikkeling was geen rechte lijn. Nvidia investeerde jarenlang in CUDA voordat de huidige AI-markt bestond. Het bedrijf trok zich ook terug uit sommige markten en deed acquisities om nieuwe onderdelen toe te voegen. Wie de strategische keuzes en achtergrond van de CEO wil begrijpen, kan verder in het profiel wie is Jensen Huang?.
Is Nvidia alleen relevant voor grote bedrijven?
Nee. Nvidia bedient verschillende groepen:
- gamers gebruiken GeForce-kaarten;
- makers en ontwerpers gebruiken RTX- en professionele GPU’s;
- ontwikkelaars draaien lokale modellen en agents op consumentenhardware, DGX Spark en straks RTX Spark;
- onderzoekers gebruiken CUDA-libraries voor simulatie en data-analyse;
- bedrijven zetten NIM, AI Enterprise en DGX-infrastructuur in;
- fabrikanten gebruiken Omniverse-technologie voor simulatie en digital twins;
- autofabrikanten en roboticabedrijven gebruiken Nvidia-platformen voor waarneming, planning en training.
Niet iedere gebruiker heeft Nvidia nodig. Een gewone laptop-CPU, Apple-silicium, een AMD-GPU, een cloud-API of een gespecialiseerde accelerator kan voor een specifieke taak slimmer zijn. Nvidia is vooral sterk wanneer brede softwareondersteuning, schaalbare GPU-rekenkracht en een geïntegreerd ecosysteem zwaar wegen.
Lees ook


Conclusie: Nvidia is een AI-platform, geen losse chip
Nvidia begon als grafisch chipbedrijf, maar is uitgegroeid tot leverancier van een volledige computerlaag voor AI. GPU’s vormen het zichtbare middelpunt. CUDA, netwerktechnologie, DGX- en RTX Spark-systemen, agentsoftware en simulatieplatformen maken het verdedigbare geheel eromheen.
Dat verklaart zowel de kracht als het risico van Nvidia. Het geïntegreerde platform kan ontwikkeling versnellen en complexe infrastructuur beheersbaar maken. Tegelijk ontstaan hoge kosten, afhankelijkheid van één ecosysteem en druk op energie, productiecapaciteit en regelgeving.
De juiste vraag is daarom niet alleen of een Nvidia-chip snel is. Belangrijker is of de volledige combinatie van hardware, software, ondersteuning en schaal past bij de eigen workload.
Veelgestelde vragen over Nvidia
Wat is Nvidia?
Nvidia is een Amerikaans technologiebedrijf dat GPU’s, netwerkproducten, AI-software en complete computersystemen ontwerpt. Het is actief in datacenters, gaming, professionele visualisatie, automotive en robotica.
Maakt Nvidia zelf zijn chips?
Nvidia ontwerpt zijn chips, maar laat een groot deel van de productie uitvoeren door gespecialiseerde fabrikanten en verpakkingspartners. Het bedrijf geldt daarom als fabless.
Waarom wordt Nvidia zoveel gebruikt voor AI?
GPU’s kunnen veel berekeningen parallel uitvoeren. Nvidia combineert die hardware met CUDA, geoptimaliseerde libraries, snelle verbindingen en complete systemen. Daardoor is er een volwassen ontwikkel- en productie-ecosysteem ontstaan.
Is CUDA hetzelfde als een Nvidia-GPU?
Nee. Een GPU is hardware. CUDA is het softwareplatform waarmee programma’s de rekenkracht van ondersteunde Nvidia-GPU’s kunnen gebruiken.
Wat is het verschil tussen GeForce en Nvidia-datacenterchips?
GeForce is vooral gericht op consumenten, gaming en creatieve toepassingen. Datacenterproducten zijn ontworpen voor langdurige bedrijfsworkloads, grote geheugencapaciteit, snelle verbindingen, beheer en ondersteuning op clusterschaal.
Is AMD een alternatief voor Nvidia?
Ja, afhankelijk van de workload. AMD biedt krachtige Instinct-accelerators en het ROCm-platform. De praktische keuze hangt onder meer af van softwarecompatibiliteit, geheugen, beschikbaarheid, cloudondersteuning en migratiekosten.
Robin HeesterOprichter
Robin Heester is mede-oprichter van AI Wereld en heeft door de jaren heen meerdere websites, nieuwsbrieven en magazines opgericht. Hij schrijft over technologie, innovatie en de maatschappelijke impact van nieuwe digitale ontwikkelingen.
Laatste reacties
- Kan inderdaad allebei waar zijnRobinHeester09-09-2026
- De Chinese AGI is een bedreiging voor de westerse democratie? En een US AGI niet? Er is nauwelijks meer sprake van democratie in de US. Ik vraag me af of het iets uitmaakt waar de eerste AGI het ‘levenslicht’ ziet. Op het moment dat een AGI werkt trekt het zich waarschijnlijk niets aan van locatie en onttrekt het zich aan iedere controle. Hoe een AGI gaat acteren is een filosofische (of Darwinistische?) vraag. Zo lang als een AGI mensen nodig heeft zal ze deze gebruiken, daarna…markvanbijnen09-09-2026
- Wie zijn die experts die dat beweren??Cas.v09-09-2026
- Is volgens X zelf aan de hand https://x.com/GlobalAffairs/status/2093130747796148634RobinHeester29-08-2026
- Wapeniseert?? Dit is een erg onbetrouwbaar bericht. Niet alleen slecht vertaald, maar ook niet controleerbaar.Cas.v28-08-2026
- Niet mijn observatie dat de toeleveringsaanvoer stabiliseert.Cas.v26-08-2026
- Ja, de transcriptie van het gesprek is gedaan met AI. Dank voor de feedback over de herhalingen, daar kan ik zeker nog wat scherper op zijn.RobinHeester21-08-2026
- Goed artikel, alleen jammer dat er zoveel Ai bij gebruikt is om het te schrijven, veel herhalingen, het had een stuk compacter gekund.🙃Cas.v21-08-2026
- Voor zover ik weet moet je bij academische publicaties vooral eerlijk en transparant zijn over hoe en waar je AI hebt gebruikt. En de oorspronkelijke informatiebronnen kunnen dan gewoon volgens APA worden vermeld. Maar daar weet ik het fijne ook (nog) niet van.RobinHeester13-08-2026
- Ik ben benieuwd wat dit gaat betekenen voor de APA verwijzingen in academische publicaties.Cas.v13-08-2026
Loading