AI-data-analyse is zeker nuttig, maar er zijn wel een aantal zaken waar je rekening mee moet houden
Persberichtbijgewerkt om
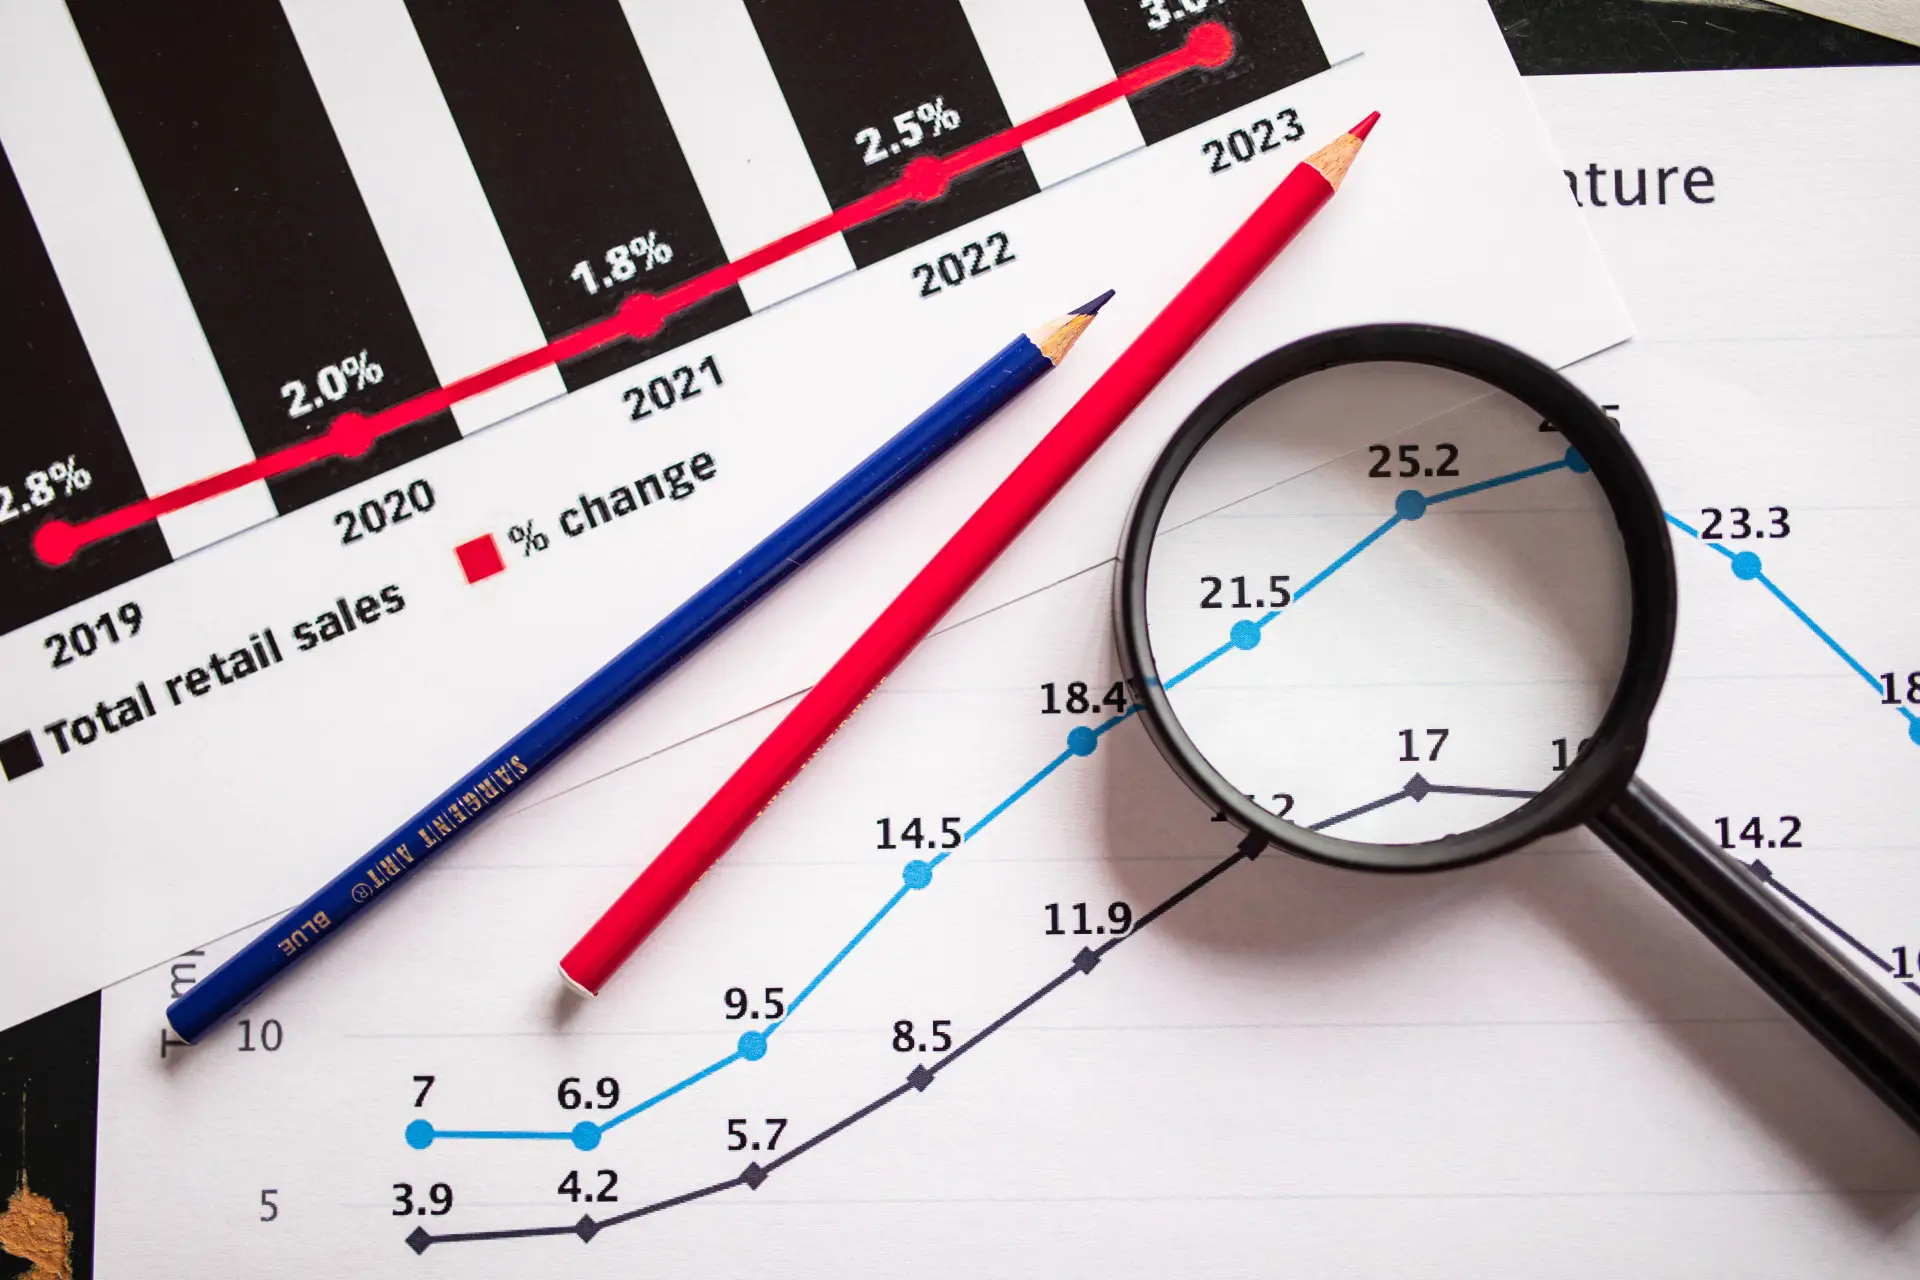
Data-analyse is inmiddels een vast onderdeel van de manier waarop bedrijven werken, beslissen en groeien. Van voorraadbeheer en klantgedrag tot personeelsplanning en risicobeoordeling: organisaties gebruiken gegevens om sneller patronen te ontdekken en betere beslissingen te nemen.
Vrijwel elke sector steunt daarop. In de zorg helpt analyse bijvoorbeeld bij het voorspellen van drukte op afdelingen, het signaleren van terugkerende complicaties en het beter afstemmen van behandelingen op patiëntengroepen.
Die ontwikkeling is nog sterker geworden door de opkomst van digitale markten. Een duidelijk voorbeeld daarvan is data-analyse bij online casino's, waarbij data inzicht geeft in speelgedrag, betaalstromen, gebruikersvoorkeuren en mogelijke signalen van risicovol gedrag.
Ook het gebruik van AI voor analyse is sterk gegroeid. Toch werkt dat alleen goed als je begrijpt waar de grenzen liggen, hoe vertekening ontstaat en welke controle nog nodig is.
Waarom AI aantrekkelijk is voor data-analyse
AI kan grote hoeveelheden informatie veel sneller verwerken dan een traditioneel analyseteam. Waar een medewerker weken nodig kan hebben om klantsegmenten, afwijkingen of trends te onderzoeken, kan een model in korte tijd miljoenen datapunten vergelijken. Dat maakt AI aantrekkelijk voor bedrijven die dagelijks werken met transacties, sensordata, gebruikersactiviteit of operationele rapportages.
Daar komt bij dat AI verbanden kan vinden die minder zichtbaar zijn op standaarddashboards. Een retailer kan bijvoorbeeld zien dat retourzendingen toenemen, maar een goed model kan ook laten zien dat die stijging samenhangt met een combinatie van levertijd, productcategorie en een bepaald type campagne.
In de financiële sector gebeurt iets vergelijkbaars wanneer systemen ongebruikelijke betaalpatronen opsporen die kunnen wijzen op fraude.
Toch betekent snelheid niet automatisch kwaliteit. Een model kan alleen werken met wat het krijgt aangeleverd. Zodra de invoer onvolledig, verouderd of slecht gestructureerd is, worden de uitkomsten minder betrouwbaar. Dat is vaak het eerste probleem dat bedrijven onderschatten wanneer zij AI inzetten als analysemiddel.
Slechte data levert slechte uitkomsten op
De kwaliteit van de brondata bepaalt in hoge mate de waarde van elke analyse. Dat lijkt vanzelfsprekend, maar in de praktijk ontstaan juist hier de meeste fouten. Gegevens uit verschillende systemen sluiten vaak niet goed op elkaar aan.
Klantnamen zijn dubbel opgeslagen, tijdstempels verschillen per regio, definities van omzet lopen tussen teams uiteen en oude records blijven ten onrechte meetellen.
Neem een logistiek bedrijf dat AI gebruikt om vertragingen te voorspellen. Als de ene database spreekt van geleverd zodra een pakket het depot verlaat, terwijl een ander systeem dezelfde status pas geeft na ontvangst door de klant, dan trekt het model verkeerde conclusies. Hetzelfde geldt in de zorg wanneer patiëntgegevens op meerdere afdelingen niet op dezelfde manier worden vastgelegd. Dan lijkt het alsof bepaalde behandelingen effectiever zijn, terwijl de registratie eenvoudigweg anders was.
Een sterk AI-project begint daarom met datacontrole, standaardisatie en duidelijke definities. Pas daarna heeft modellering zin. Zonder die basis lijkt de analyse slim, terwijl de output feitelijk op een scheve fundering rust.
Bias in AI is een praktisch probleem, geen theoretisch risico
Een van de grootste misverstanden is dat AI neutraal zou zijn. In werkelijkheid nemen modellen patronen over uit historische data. Als die geschiedenis scheef is, wordt die scheefgroei vaak versterkt. Dat maakt bias geen abstract ethisch debat, maar een direct zakelijk en operationeel risico.
Een voorbeeld uit recruitment maakt dat duidelijk. Als een organisatie jarenlang vooral kandidaten uit een beperkte groep heeft aangenomen, kan een model leren dat die profielen succesvoller zijn. Vervolgens krijgen andere kandidaten structureel lagere scores, zelfs wanneer zij geschikt zijn. In de kredietsector kan hetzelfde gebeuren wanneer postcode, opleidingsniveau of betaalgedrag indirect samenhangt met sociaaleconomische verschillen.
Daarom moet elk model worden getest op onevenwichtige uitkomsten. Kijk niet alleen naar algemene nauwkeurigheid, maar ook naar verschillen tussen groepen, regio's, leeftijdscategorieën of klanttypes. Bovendien is het verstandig om variabelen kritisch te beoordelen. Soms lijkt een datapunt onschuldig, terwijl het in de praktijk een vervanging is voor gevoelige kenmerken.
Context blijft onmisbaar bij het lezen van resultaten
AI kan patronen aanwijzen, maar begrijpt de bedrijfscontext niet vanzelf. Dat is een belangrijk verschil.
Een model kan melden dat de verkoop in een bepaalde regio plots daalt, maar zonder context weet het niet of daar een lokaal distributieprobleem speelde, een concurrent actief werd of een product tijdelijk niet leverbaar was.
In ziekenhuizen kan een systeem bijvoorbeeld signaleren dat heropnames stijgen bij een specifieke patiëntengroep. Dat lijkt direct relevant, maar artsen en planners moeten vervolgens bepalen of het gaat om seizoensinvloeden, veranderde triage, personeelstekorten of een echt medisch patroon. Als context ontbreekt, loopt het risico om een technisch correcte maar praktisch misleidende uitkomst te sturen.
Bedrijven doen er daarom goed aan om analyses altijd te koppelen aan domeinkennis. Data scientists, operationele teams, juristen en managers moeten samen beoordelen wat een uitkomst werkelijk betekent. Juist die samenwerking voorkomt dure missers.
Privacy, toestemming en dataminimalisatie verdienen meer aandacht
Hoe krachtiger de analyse, hoe groter de verantwoordelijkheid rond privacy. Veel organisaties verzamelen meer gegevens dan zij daadwerkelijk nodig hebben. Dat vergroot de risico's zonder de analyse automatisch beter te maken. Zeker wanneer AI wordt gebruikt voor gedragsanalyse, segmentatie of voorspellingen over individuen, moet scherp worden gekeken naar doel, grondslag en bewaartermijn.
Dataminimalisatie is daarom meer dan een juridisch vinkje. Het dwingt bedrijven om beter na te denken over welke signalen daadwerkelijk waarde hebben. Minder data kan leiden tot een helderder model, lagere opslagkosten en minder risico bij incidenten. Dat is zowel praktisch als verantwoord.
Transparantie maakt AI bruikbaar voor besluitvorming
Veel AI-systemen geven een uitkomst zonder duidelijke uitleg. Dat is problematisch wanneer de analyse gevolgen heeft voor klanten, medewerkers of investeringen.
Een manager die alleen een risicoscore ziet, kan moeilijk beoordelen of de uitkomst logisch is. Daardoor wordt blind vertrouwen al snel een gewoonte.
Een bruikbaar systeem laat daarom zien welke factoren meegewogen zijn. Bij fraudedetectie kan dat betekenen dat een model aangeeft dat een waarschuwing samenhangt met een ongebruikelijk tijdstip, een afwijkend transactietempo en een nieuw apparaat. In de klantanalyse kan zichtbaar worden dat de opzegkans vooral wordt bepaald door recente serviceproblemen, prijswijzigingen en afnemende activiteit.
De uitlegbaarheid is niet alleen belangrijk voor governance. Teams nemen ook sneller betere beslissingen wanneer ze begrijpen waarom een model iets signaleert. Transparantie verhoogt dus zowel de controle als de praktische toepasbaarheid.
Menselijke controle blijft nodig, ook bij sterke modellen
Zelfs een model met hoge prestaties moet worden bewaakt. Data verandert, gedrag verschuift en markten reageren op nieuwe omstandigheden. Een systeem dat vorig jaar goed werkte, kan vandaag minder accuraat zijn doordat klantvoorkeuren, regelgeving of externe factoren zijn veranderd. Dat heet model drift en het komt vaker voor dan veel bedrijven denken.
Stel dat een e-commerceplatform AI gebruikt om vraag te voorspellen. Tijdens een stabiele periode werkt dat prima. Zodra inflatie, seizoenspieken of leveringsproblemen optreden, kunnen oude patronen hun waarde verliezen. Zonder periodieke herijking ontstaan er verkeerde voorraadbeslissingen. In de zorg geldt hetzelfde wanneer behandelprotocollen veranderen en historische data daardoor minder representatief worden.
Menselijke controle betekent daarom meer dan alleen een laatste goedkeuring. Het vraagt om vaste evaluatiemomenten, prestatiecontroles, steekproeven en duidelijke escalatie wanneer de resultaten afwijken van de werkelijkheid. AI is een hulpmiddel, geen vervanging voor professioneel oordeel.
Een sterke aanpak begint klein en meetbaar
Bedrijven halen meestal de beste resultaten wanneer zij AI voor data-analyse stapsgewijs introduceren. Begin met een afgebakend probleem, zoals het voorspellen van klantverloop, het herkennen van afwijkende facturen of het plannen van onderhoud op basis van sensordata. Zo blijft zichtbaar of het model daadwerkelijk waarde toevoegt.
Daarnaast moet vooraf worden bepaald welke maatstaven hieraan dienen te worden toegepast. Gaat het om hogere nauwkeurigheid, minder handmatig werk, snellere besluitvorming of lagere operationele kosten? Zonder heldere doelen ontstaat al snel een technisch project zonder duidelijk zakelijk resultaat. Juist meetbare toepassingen laten zien waar AI nuttig is en waar traditionele analyse beter past.
AI maakt data-analyse krachtiger, sneller en vaak scherper, maar alleen wanneer de basis op orde is. Wie zorgvuldig omgaat met datakwaliteit, bias, privacy, context en controle, kan er veel mee winnen. Wie dat overslaat, krijgt vooral schijnzekerheid. Daar zit precies het verschil tussen slimme inzet en onnodig risico.
Berichten van de redactie van AI Wereld. Denk aan: persberichten, ingezonden blogposts en meer.
Populair nieuws
AI-aandelen blijven onrustig: ASML en Besi sluiten opnieuw lager
Claude mag geen bestaande games meer namaken: Anthropic grijpt in
AI op je eigen pc: Sam Altman ziet liever gedeelde rekenkracht
Goedemorgen AI: wat weet een incassobureau over jou?
Podcast: Wat weet een incassobureau over jou door AI?
Jan Rotmans wil zijn kennis laten voortleven met een AI-tweeling
Laatste reacties
- Haha! Je bent gelukkig niet de enige hoor. Wel een van de weinige die reageert. :)
 RobinHeester30-09-2026
- Toch wel leuk wat je in elkaar hebt gezet🙃 volgens mij ben ik de enige lezer!Cas.v28-09-2026
- Kan inderdaad allebei waar zijnRobinHeester09-09-2026
- De Chinese AGI is een bedreiging voor de westerse democratie? En een US AGI niet? Er is nauwelijks meer sprake van democratie in de US. Ik vraag me af of het iets uitmaakt waar de eerste AGI het ‘levenslicht’ ziet. Op het moment dat een AGI werkt trekt het zich waarschijnlijk niets aan van locatie en onttrekt het zich aan iedere controle. Hoe een AGI gaat acteren is een filosofische (of Darwinistische?) vraag. Zo lang als een AGI mensen nodig heeft zal ze deze gebruiken, daarna…markvanbijnen09-09-2026
- Wie zijn die experts die dat beweren??Cas.v09-09-2026
- Is volgens X zelf aan de hand https://x.com/GlobalAffairs/status/2093130747796148634RobinHeester29-08-2026
- Wapeniseert?? Dit is een erg onbetrouwbaar bericht. Niet alleen slecht vertaald, maar ook niet controleerbaar.Cas.v28-08-2026
- Niet mijn observatie dat de toeleveringsaanvoer stabiliseert.Cas.v26-08-2026
- Ja, de transcriptie van het gesprek is gedaan met AI. Dank voor de feedback over de herhalingen, daar kan ik zeker nog wat scherper op zijn.RobinHeester21-08-2026
- Goed artikel, alleen jammer dat er zoveel Ai bij gebruikt is om het te schrijven, veel herhalingen, het had een stuk compacter gekund.🙃Cas.v21-08-2026