Nvidia RTX Spark uitgelegd: lokale AI op Windows en verschil met DGX Spark
Blogvrijdag, 28 augustus 2026 om 10:00
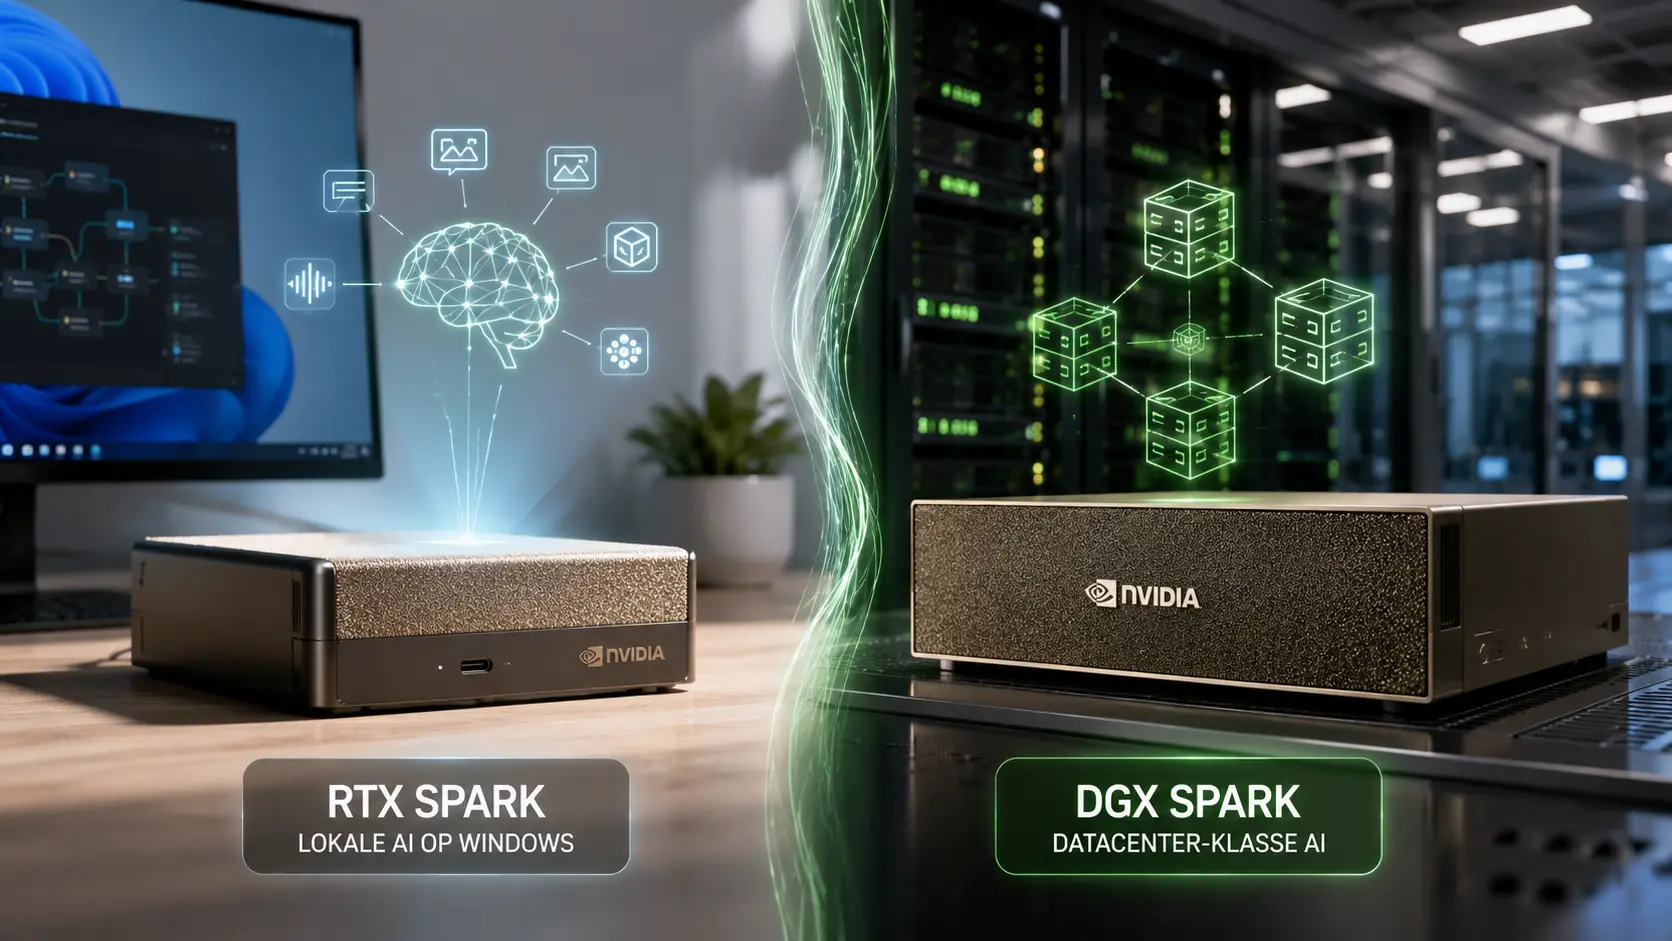
Nvidia RTX Spark is een nieuwe chip voor Windows-pc’s die een Blackwell RTX-GPU, een twintigkernige Grace-processor en maximaal 128 GB gedeeld geheugen combineert. Nvidia richt het platform op lokale AI, persoonlijke AI-agents, creatieve software en gaming. Het verschijnt niet als losse videokaart, maar in laptops en compacte desktops van onder meer ASUS, Dell, HP, Lenovo, Microsoft en MSI.
Het geheugen moet een bekend knelpunt bij grotere lokale modellen verminderen. RTX Spark is op 25 augustus 2026 echter nog niet algemeen verkrijgbaar. Nvidia noemt het najaar van 2026; Nederlandse prijzen, definitieve OEM-configuraties en onafhankelijke benchmarks ontbreken nog.
Wat is Nvidia RTX Spark?
RTX Spark is een system-on-chipplatform voor Windows-computers. Het combineert verschillende onderdelen die in een traditionele pc meestal over aparte chips en geheugenpools zijn verdeeld:
| Onderdeel | Aangekondigde specificatie |
| GPU | Blackwell RTX-GPU met maximaal 6.144 CUDA-cores |
| CPU | Nvidia Grace-CPU met maximaal 20 Arm-cores |
| AI-rekenkracht | Maximaal 1 petaflop bij FP4 |
| Geheugen | Maximaal 128 GB unified memory |
| Verbinding CPU-GPU | NVLink-C2C |
| Besturingssysteem | Windows |
| Vormfactor | Dunne laptops en compacte desktops |
| Geplande beschikbaarheid | Najaar 2026 |
Dit zijn maxima. Een OEM kan minder geheugen, een andere vermogenslimiet of afwijkende koeling kiezen. RTX Spark is ook geen nieuwe GeForce-kaart: het gebruikt een Grace-processor op basis van Arm en één coherente geheugenarchitectuur, waar een traditionele pc een x86-CPU en losse GPU met eigen videogeheugen combineert.
Meer achtergrond over de rol van de fabrikant staat in Wat is Nvidia?. Voor de technische basis achter GPU-versnelling is ook de uitleg over GPU’s en hun belang voor AI relevant.
Waarom 128 GB unified memory belangrijk is voor lokale AI
Bij het lokaal uitvoeren van een taalmodel moeten de modelgewichten, de context, tijdelijke berekeningen en andere runtimegegevens in het beschikbare geheugen passen. Een losse GPU met 16 of 24 GB videogeheugen kan uitstekende prestaties leveren, maar grotere modellen vereisen dan agressieve quantisatie, gedeeltelijke verwerking via het systeemgeheugen of meerdere GPU’s.
RTX Spark biedt maximaal 128 GB unified memory. CPU en GPU werken binnen dezelfde geheugenpool, waardoor gegevens minder vaak tussen regulier werkgeheugen en afzonderlijk videogeheugen hoeven te worden gekopieerd. Dat helpt bij quantized taalmodellen met tientallen miljarden parameters, lange contexten, multimodale modellen, generatieve media, lokale documentanalyse en meerdere actieve agents.
Nvidia stelt dat RTX Spark onder geschikte omstandigheden modellen met 120 miljard parameters en zeer lange contexten lokaal kan uitvoeren. Dat is geen garantie dat ieder 120B-model snel of met zijn maximale context werkt. Een 4-bit modelbestand gebruikt veel minder geheugen dan hetzelfde model in FP16, maar inference vraagt daarnaast geheugen voor de KV-cache, runtime, agenttools en het besturingssysteem.
Unified memory is bovendien niet hetzelfde als 128 GB exclusief GPU-geheugen. Windows, achtergrondprocessen en creatieve applicaties gebruiken dezelfde pool. Ook geheugenbandbreedte, koeling en vermogenslimieten bepalen hoeveel tokens per seconde een systeem werkelijk produceert.
Vergelijk daarom hetzelfde model, dezelfde quantisatie en contextlengte. Onze keuzehulp voor een Nvidia-GPU voor lokale AI behandelt deze afweging uitgebreider.
Wat betekenen 1 petaflop FP4 en 6.144 CUDA-cores?
Nvidia noemt maximaal één petaflop aan FP4 AI-rekenkracht. FP4 gebruikt vier bits om getallen weer te geven en is gericht op efficiënte AI-inference. Het cijfer zegt iets over theoretische piekcapaciteit bij een specifieke precisie, maar niet rechtstreeks hoeveel woorden, beelden of videotokens een toepassing per seconde verwerkt.
Vergelijk één petaflop FP4 daarom niet rechtstreeks met FP16-prestaties, gaming-TFLOPS of een andere architectuur. De werkelijke snelheid hangt af van modelondersteuning, quantisatie, geheugenbandbreedte, context, koeling en optimalisaties in bijvoorbeeld CUDA, TensorRT of llama.cpp.
Hetzelfde geldt voor 6.144 CUDA-cores. CUDA-cores uit verschillende generaties zijn niet één op één vergelijkbaar. Wie wil begrijpen waarom Nvidia’s software-ecosysteem minstens zo belangrijk is als de hardware, kan verder lezen in Wat is CUDA?.
RTX Spark draait op Windows on Arm
De Grace-CPU gebruikt de Arm-architectuur. RTX Spark-systemen zijn daardoor Windows-on-Arm-computers en geen conventionele x86-pc’s. Dat heeft gevolgen voor softwarecompatibiliteit.
Er zijn drie mogelijke routes:
- Native Windows ARM64-software. Dit biedt doorgaans de schoonste integratie met Windows, lokale bestanden en desktopapplicaties. Nvidia heeft Windows ARM64-ondersteuning voor RTX Spark toegevoegd aan TensorRT for RTX 1.6.
- Windows Subsystem for Linux. WSL biedt een Linux-omgeving binnen Windows en is nuttig voor Python, containers en AI-toolchains die primair voor Linux zijn ontwikkeld. Op RTX Spark moeten pakketten en containerimages wel een geschikte Arm64-versie hebben.
- Emulatie van x64-programma’s. Windows on Arm kan veel bestaande x64-software emuleren, maar emulatie is geen garantie voor volledige functionaliteit of optimale prestaties. Vooral drivers, CUDA-extensies, plug-ins, anti-cheatsoftware en laag-niveau optimalisaties verdienen extra controle.
Controleer dus specifiek of software native ARM64 ondersteunt, aantoonbaar onder emulatie werkt of als Linux Arm64-pakket beschikbaar is. Niet iedere bestaande workflow zal bij introductie gelijkwaardig zijn aan een gevestigde x86-werkplek.
Hoe kun je lokale AI op RTX Spark draaien?
Omdat RTX Spark nog niet algemeen verkrijgbaar is, bestaat er nog geen universele installatieprocedure voor alle toekomstige laptops en desktops. De praktische route zal naar verwachting uit de volgende stappen bestaan.
1. Kies tussen native Windows en WSL
Gebruik native Windows voor ARM64-software die met Windows-apps moet samenwerken en WSL voor Linux-pakketten of containers. Installeer in WSL niet zelf een Linux-GPU-driver: CUDA on WSL gebruikt de Windows-driver als basis. Volg bij levering de productspecifieke instructies.
2. Installeer een geschikte inference-engine
Mogelijke routes zijn TensorRT for RTX, llama.cpp, Ollama, LM Studio en vLLM, mits de gekozen versie Windows ARM64 of Linux Arm64 op RTX Spark ondersteunt.
Onze handleiding voor DeepSeek lokaal installeren met Ollama en LM Studio toont de basisworkflow. Controleer bij RTX Spark eerst iedere dependency op Arm64-ondersteuning.
3. Kies een passend open model
RTX Spark is vooral relevant voor downloadbare modellen uit onder meer Llama, Mistral AI, Qwen, DeepSeek en Nemotron. Gesloten modellen die alleen via een API beschikbaar zijn, worden niet lokaal uitvoerbaar door krachtigere hardware. Het actuele aanbod van downloadbare modellen staat ook in het dossier open-source AI.
Controleer licentie, parameters, quantisatie, contextlengte, runtimeondersteuning, extra geheugengebruik en kwaliteit voor Nederlands. Een model dat op papier past, is niet per definitie snel of geschikt voor zakelijk gebruik.
4. Start eerst een lokale modelserver
Laat de inference-engine eerst alleen luisteren op localhost. Test geheugen, snelheid en stabiliteit voordat het model documenten, applicaties of andere apparaten mag bereiken.
5. Verbind een agent met beperkte rechten
Een AI-agent kan daarna bestanden zoeken, code uitvoeren of applicaties bedienen. Begin met één map, een apart account en weinig toegestane acties.
De Nvidia Agent Toolkit kan binnen dit ecosysteem helpen bij het bouwen en optimaliseren van agentworkflows. Voor koppelingen tussen een model en externe tools is daarnaast onze veilige handleiding voor Model Context Protocol belangrijk.
6. Meet de volledige workflow
Meet niet alleen tokens per seconde, maar ook documentzoekopdrachten, toolcalls, contextopbouw, cloudfallback, langdurige prestaties en energiegebruik.
OpenShell maakt lokale agents niet automatisch veilig
Nvidia en Microsoft positioneren RTX Spark nadrukkelijk voor persoonlijke AI-agents. Daarbij moet Nvidia OpenShell extra beveiliging bieden. OpenShell gebruikt afzonderlijke sandboxes en beleid voor toegang tot bestanden, processen, netwerkverbindingen en externe tools.
Beleid buiten het model is sterker dan uitsluitend een systeemprompt, maar OpenShell vervangt geen goed toegangsbeheer. Een lokale agent kan nog steeds schade veroorzaken wanneer hij te ruime rechten krijgt. Gebruik daarom minimaal:
- een afzonderlijk account of geïsoleerde werkomgeving;
- standaard geblokkeerde uitgaande netwerktoegang;
- expliciete toestemming voor risicovolle handelingen;
- beperkte toegang tot mappen en inloggegevens;
- logging van toolcalls en beleidswijzigingen;
- gecontroleerde plug-ins, skills en MCP-servers;
- actuele back-ups buiten het bereik van de agent.
“Lokaal” betekent ook niet automatisch “privé”. Een toepassing kan telemetrie versturen, een zoekfunctie kan externe diensten gebruiken en een hybride agent kan gevoelige prompts naar een cloudmodel routeren. Inventariseer daarom de volledige datastroom. Zie ook onze dossiers over privacy en cybersecurity.
RTX Spark versus DGX Spark, losse RTX-GPU en cloud
| Platform | Besturingssysteem | Geheugenmodel | Sterkste toepassing | Belangrijkste beperking |
| RTX Spark | Windows on Arm, eventueel WSL | Tot 128 GB unified memory | Mobiele of compacte Windows-pc voor lokale AI, agents, creatie en gaming | Nog niet algemeen verkrijgbaar; Arm-compatibiliteit controleren |
| DGX Spark | Nvidia DGX OS/Linux | 128 GB coherent unified memory | Compacte, toegewijde AI-ontwikkelmachine | Minder gericht op gewone Windows-apps en gaming |
| GeForce of RTX Pro | Windows of Linux, meestal x86-pc | Afzonderlijk VRAM en systeemgeheugen | Bewezen desktopsoftware, hoge GPU-prestaties en brede keuze | Grote modellen worden begrensd door beschikbaar VRAM |
| DGX Station | Windows- of Ubuntu-uitvoering | Tot 748 GB coherent geheugen | Frontiermodellen en meerdere enterprise-agents | Veel groter, duurder en bedoeld voor organisaties |
| Cloud-API | Browser, app of API-client | Geheugen beheerd door provider | Snel beginnen, schaalbare piekbelasting en gesloten frontiermodellen | Terugkerende kosten, internetafhankelijkheid en externe dataverwerking |
RTX Spark en DGX Spark delen cijfers zoals een twintigkernige Arm-CPU, 128 GB geheugen en maximaal één petaflop FP4, maar zijn niet hetzelfde product. DGX Spark is een compacte Grace Blackwell-ontwikkelmachine met DGX OS, opslag en AI-netwerkvoorzieningen. RTX Spark is een Windows-platform voor OEM-laptops en desktops, inclusief de bredere RTX-stack voor graphics en creatie.
Een losse GeForce- of RTX Pro-GPU blijft logisch wanneer modellen in het VRAM passen, x86-compatibiliteit belangrijk is of een desktop kan worden uitgebreid. Vergelijk daarnaast software, geheugen en prijs in Nvidia versus AMD voor AI.
DGX Station zit meerdere klassen hoger, met een GB300-chip, maximaal 748 GB coherent geheugen en twintig petaflops FP4. Het is enterprise-infrastructuur voor zeer grote modellen en gelijktijdige agents.
Cloud-API’s blijven zinvol voor incidenteel gebruik, piekbelasting en gesloten modellen. Een hybride opzet kan gevoelige taken lokaal houden.
Voor wie is RTX Spark interessant?
RTX Spark kan interessant worden voor:
- ontwikkelaars die grote open modellen lokaal op een Windows-laptop willen testen;
- professionals die meer dan gebruikelijk GPU-geheugen nodig hebben voor beeld, video of 3D;
- gebruikers die een persoonlijke agent lokaal en langdurig willen laten draaien;
- organisaties die gevoelige documenten niet standaard naar een externe modelprovider willen sturen;
- teams die lokaal willen prototypen en later naar Nvidia-cloud- of datacenterhardware opschalen.
Een compact desktopmodel zal waarschijnlijk geschikter zijn voor een agent die dag en nacht actief blijft. Een laptop is aantrekkelijker wanneer draagbaarheid essentieel is, maar accuduur, geluid en langdurige prestaties moeten onafhankelijk worden getest.
Wie kan beter wachten?
Wacht op concrete modellen en reviews wanneer je vandaag hardware nodig hebt, prijs doorslaggevend is, je workflow x86-drivers of specifieke CUDA-extensies vereist, je vaste software zonder workaround moet draaien, 24 of 32 GB VRAM al genoeg is of je organisatie nog geen agentbeleid heeft. RTX Spark is bovendien niet bedoeld als vervanging voor datacenterhardware waarmee grote modellen volledig worden getraind.
Vergelijk straks systemen met dezelfde modelversie, quantisatie, context en stroominstelling. Algemene “AI performance”-scores zijn onvoldoende voor een aankoopbeslissing.
Koopchecklist voor RTX Spark
Controleer vóór bestelling:
- Is 128 GB daadwerkelijk aanwezig of alleen beschikbaar op het topmodel?
- Werken je inference-engine, Python-pakketten en containers op ARM64?
- Hoeveel geheugen blijft vrij na het starten van Windows?
- Welke prestaties haalt je eigen model bij een realistische context?
- Kan het systeem langere tijd presteren zonder sterke throttling?
- Zijn opslag en netwerk snel genoeg voor je modellen en datasets?
- Wat zijn garantie, reparatiemogelijkheden en zakelijke ondersteuning?
- Is lokaal draaien over drie jaar goedkoper dan je verwachte API-verbruik?
Conclusie
Nvidia RTX Spark kan een belangrijk nieuw platform worden voor lokale AI op Windows. Vooral de combinatie van maximaal 128 GB unified memory, CUDA en een compacte vormfactor onderscheidt het van gewone AI-pc’s.
De aangekondigde specificaties zijn veelbelovend, maar nog geen aankoopbewijs. Op 25 augustus 2026 ontbreken algemene beschikbaarheid, definitieve prijzen en onafhankelijke praktijktests. Wacht daarom op het concrete systeem, controleer Arm64-compatibiliteit en vergelijk prestaties met DGX Spark, losse RTX-GPU’s en cloudkosten op basis van je eigen modellen.
Veelgestelde vragen
Is Nvidia RTX Spark al te koop?
Nog niet algemeen. Nvidia heeft laptops en compacte desktops voor het najaar van 2026 aangekondigd. Op 25 augustus 2026 verwijst de officiële productpagina nog naar een notificatie voor beschikbaarheid.
Kan RTX Spark een model met 120 miljard parameters draaien?
Nvidia zegt dat geschikte 120B-modellen lokaal kunnen draaien. Praktische snelheid hangt af van quantisatie, context, runtime en vrij geheugen.
Is RTX Spark hetzelfde als DGX Spark?
Nee. DGX Spark is een compacte Linux-georiënteerde ontwikkelmachine; RTX Spark is een Windows-platform voor laptops en desktops met RTX-graphics.
Is één petaflop FP4 sneller dan een high-end GeForce-kaart?
Nee, dat volgt niet uit dit cijfer. FP4 is een lage AI-precisie; werkelijke prestaties hangen af van model, software, geheugen en koeling.
Is lokale AI op RTX Spark volledig privé?
Alleen als data, modellen en tools lokaal blijven. Cloudfallback, telemetrie, webzoekfuncties en externe tools kunnen alsnog gegevens versturen.
Robin HeesterOprichter
Robin Heester is mede-oprichter van AI Wereld en heeft door de jaren heen meerdere websites, nieuwsbrieven en magazines opgericht. Hij schrijft over technologie, innovatie en de maatschappelijke impact van nieuwe digitale ontwikkelingen.
Populair nieuws
Laatste reacties
- Is volgens X zelf aan de hand https://x.com/GlobalAffairs/status/2093130747796148634RobinHeester29-08-2026
- Wapeniseert?? Dit is een erg onbetrouwbaar bericht. Niet alleen slecht vertaald, maar ook niet controleerbaar.Cas.v28-08-2026
- Niet mijn observatie dat de toeleveringsaanvoer stabiliseert.Cas.v26-08-2026
- Ja, de transcriptie van het gesprek is gedaan met AI. Dank voor de feedback over de herhalingen, daar kan ik zeker nog wat scherper op zijn.RobinHeester21-08-2026
- Goed artikel, alleen jammer dat er zoveel Ai bij gebruikt is om het te schrijven, veel herhalingen, het had een stuk compacter gekund.🙃Cas.v21-08-2026
- Voor zover ik weet moet je bij academische publicaties vooral eerlijk en transparant zijn over hoe en waar je AI hebt gebruikt. En de oorspronkelijke informatiebronnen kunnen dan gewoon volgens APA worden vermeld. Maar daar weet ik het fijne ook (nog) niet van.RobinHeester13-08-2026
- Ik ben benieuwd wat dit gaat betekenen voor de APA verwijzingen in academische publicaties.Cas.v13-08-2026
- Wie wordt er beter van.....zal Meta wel zijnhenk.h10-07-2026
- Wat voor weer wordt het vandaaghenk.h03-07-2026
- Dit artikel is van 1 april, dus deze belasting is niet echt. Gelukkig maar. :)RobinHeester12-05-2026
Loading