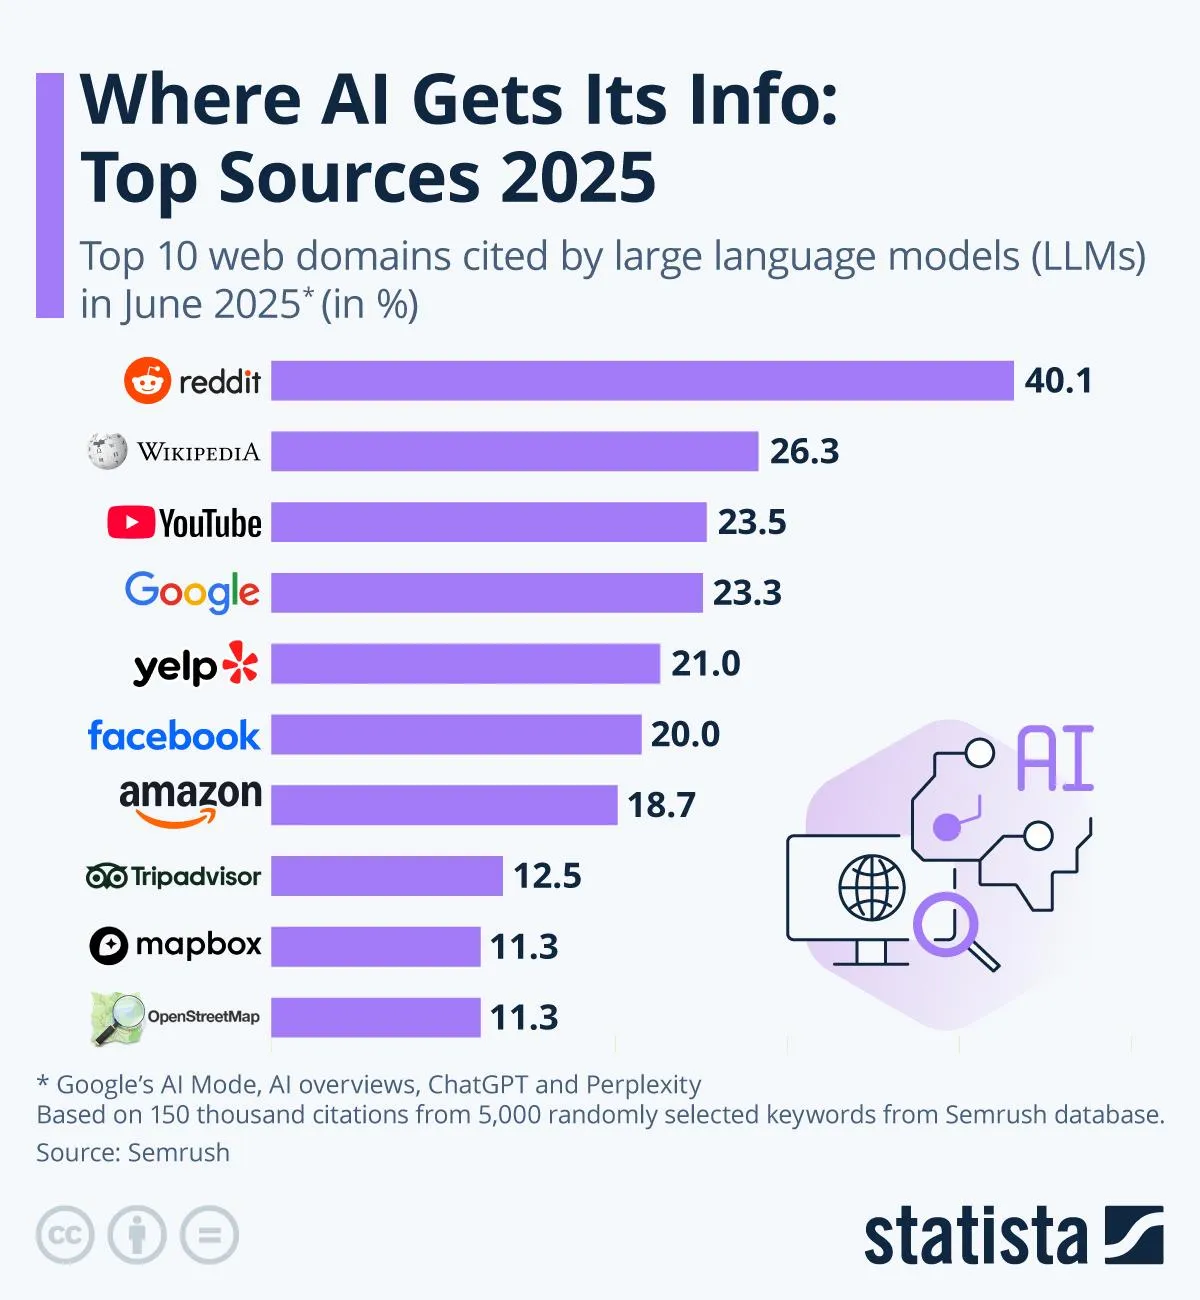
In juni 2025 blijkt uit een overzicht van Semrush dat grote taalmodellen (LLM’s) zoals ChatGPT, Perplexity en Google’s AI-mode voor maar liefst 40,1 % van hun webcitaten terugvallen op Reddit.
Daarna volgen Wikipedia (26,3 %), YouTube (23,5 %), Google zelf (23,3 %), Yelp (21,0 %), Facebook (20,0 %), Amazon (18,7 %), Tripadvisor (12,5 %) en zowel Mapbox als OpenStreetMap (elk 11,3 %).
Je kunt de voordelen en nadelen kort opsommen:
- Pluspunt: het maakt modellen rijker, menselijker en veelzijdiger.
- Minpunt: ze kunnen daardoor óók chaotischer, bevooroordeeld of minder betrouwbaar worden.
Ook gebeurt dit vaak zonder toestemming van de eigenaars van de websites zelf. Dat maakt het lastig om te beoordelen. Het is openbare data, maar het is niet helemaal te verantwoorden.
Voordelen van zulke bronnen
- Actuele en diverse perspectieven: Reddit bevat meningen en ervaringen uit de praktijk. Daardoor krijgen AI’s toegang tot actuele trends en uiteenlopende stemmen.
- Breed en gestructureerd referentiekader: Wikipedia biedt veel omschrijvingen en basisinformatie over uiteenlopende thema’s. Visuals via YouTube verrijken dat met uitleg.
- Zoeksystemen als Google en platforms zoals Yelp versterken relevantie en gebruiksvriendelijkheid, met directe toegang tot bedrijfsinformatie of reviews.
Nadelen en kanttekeningen
- Betrouwbaarheid van gebruikerscontent: Reddit, Facebook en Yelp bevatten persoonlijke opvattingen—die niet altijd kloppen.
- Risico op misinformatie of bias: AI kan vooroordelen of ongefundeerde claims oppikken en reproduceren.
- Afhankelijkheid van commerciële bronnen: Amazon en Google kunnen marketingaandacht boven objectieve informatie duwen.
- Beperkte objectiviteit bij reviewplatforms: TripAdvisor en Yelp focussen op consumentengebaseerde ervaringen, wat nuance kan missen.
AI: steeds meer een socialmediapersoonlijkheid?
AI’s worden niet letterlijk persoonlijkheden, maar dit beeld ontstaat wel:
- Stijl beïnvloed door gebruikerscontent: Als AI zwaar leunt op Reddit en Facebook, neemt de toon van informele discussies toe.
- Mimicry van gemeenschapsculturen: Bij content van platformen zoals Reddit of TikTok imiteren AI’s informele, trendgevoelige spreekstijlen.
- Beperkte authentieke identiteit: AI is geen individu, maar de verzamelde stem van talloze online bijdragen. Daardoor lijkt het alsof AI “persoonlijk” reageert, maar in essentie is het een echo van menselijke input.
Markt- en technische context
- Semrush baseerde het overzicht op 150.000 citaten uit 5.000 willekeurig geselecteerde zoekwoorden uit hun database—redelijk representatief qua dataomvang .
- De mix van platforms benadrukt dat AI-systemen zich steeds meer voeden met gebruikersgegenereerde content, samen met traditionele encyclopedische en multimediabronnen.
De voordelen van LLM’s die zichzelf trainen op zulke websites
- Veelzijdige kennisbron Door data uit Wikipedia, YouTube, Yelp, Tripadvisor en Reddit te gebruiken, krijgen modellen een enorm breed scala aan informatie: van encyclopedische feiten tot persoonlijke ervaringen, discussies, reviews en geografische data. Dat maakt ze flexibel — ze kunnen zowel uitleggen hoe een motor werkt als tips geven voor een vakantie in Lissabon.
- Meer context en nuance Social media en review-sites (zoals Reddit, Facebook en Amazon) bevatten meningen, humor, emoties en culturele verwijzingen die je in puur wetenschappelijke teksten niet vindt. Daardoor kan een model beter aanvoelen hoe mensen praten en denken.
- Actuele en praktische info Wikipedia wordt snel bijgewerkt, YouTube en Reddit volgen trends bijna real-time, en sites als Yelp en Tripadvisor geven zicht op wat er nú speelt. Dat helpt een model relevanter en actueler te antwoorden.
- Multimodale inspiratie YouTube-data brengt video-transcripten binnen, Mapbox en OpenStreetMap voegen geografische kennis toe. Dat opent de deur voor antwoorden die tekst, locatie en beeld beter combineren.
Lees ook


De nadelen en risico’s
- Kwaliteit is niet altijd top Niet alle bronnen zijn even betrouwbaar. Wikipedia kan fouten bevatten, Yelp- en Amazon-reviews kunnen nep zijn, en Facebook-posts zijn vaak puur subjectief. Als het model daar te veel op vertrouwt, kan het verkeerde of misleidende info geven.
- Vooroordelen en bubbels Social media en fora (zoals Reddit of Facebook) hebben hun eigen culturen en vooroordelen. Dat kan ertoe leiden dat het model die biases overneemt, of juist minder goed omgaat met minderheidsperspectieven.
- Privacy en ethiek Veel van deze data is ooit geplaatst zonder dat mensen wisten dat het gebruikt kon worden om AI te trainen. Dat roept ethische vragen op, zeker bij persoonlijke posts of reviews.
- Versterking van commercie en manipulatie Reviewsites en platforms hebben ook veel marketing- en reclame-inhoud. Als een model dat oppikt, kan het onbedoeld commerciële boodschappen versterken of verkeerde prioriteiten geven.
- Contextverlies Een grap op Reddit of ironie in een Facebook-post kan verkeerd worden geïnterpreteerd, waardoor het model iets serieus neemt dat bedoeld was als sarcasme (of andersom).
Robin HeesterOprichter
Robin Heester is mede-oprichter van AI Wereld en heeft door de jaren heen meerdere websites, nieuwsbrieven en magazines opgericht. Hij schrijft over technologie, innovatie en de maatschappelijke impact van nieuwe digitale ontwikkelingen.
Populair nieuws
AI-aandelen veren op na forse koersval: Nvidia, ASML en chipsector herstellen
Anthropic wil tot 64 miljard dollar ophalen bij beursgang, Nvidia en Google investeren extra
CoreWeave verdrievoudigt bijna omzet, maar AI-bedrijf verliest 709 miljoen dollar
AI-bedrijf Databricks investeert half miljard in Nederland en verdubbelt team
Goedemorgen AI: Claude gaat verder dan de chat, Meta komt met goedkopere AI
Zo laat je je hond of kat praten en dansen met AI: deze prompts maken het mogelijk
Laatste reacties
- Hi! In de eerste zin van het artikel geven we aan dat het gaat om wat Ouders & Onderwijs vindt. Ik denk ook niet dat die organisatie voor alle ouders spreekt.RobinHeester10-11-2026
- Ik verbaas mij er over, dat het hier gebracht wordt alsof een onbekende organisatie als "ouders & onderwijs". Namens alle ouders spreekt. Ik als ouder van een dichter op de basisschool en persoonlijk zeer ervaren met AI, ben er op tegen dat AI op de basisschool aanwezig is. Ik deel de mening van deze organisatie dan ook helemaal niet en ondersteun het verbod volledig.wwigman10-11-2026
- Haha! Je bent gelukkig niet de enige hoor. Wel een van de weinige die reageert. :)RobinHeester30-09-2026
- Toch wel leuk wat je in elkaar hebt gezet🙃 volgens mij ben ik de enige lezer!Cas.v28-09-2026
- Kan inderdaad allebei waar zijnRobinHeester09-09-2026
- De Chinese AGI is een bedreiging voor de westerse democratie? En een US AGI niet? Er is nauwelijks meer sprake van democratie in de US. Ik vraag me af of het iets uitmaakt waar de eerste AGI het ‘levenslicht’ ziet. Op het moment dat een AGI werkt trekt het zich waarschijnlijk niets aan van locatie en onttrekt het zich aan iedere controle. Hoe een AGI gaat acteren is een filosofische (of Darwinistische?) vraag. Zo lang als een AGI mensen nodig heeft zal ze deze gebruiken, daarna…markvanbijnen09-09-2026
- Wie zijn die experts die dat beweren??Cas.v09-09-2026
- Is volgens X zelf aan de hand https://x.com/GlobalAffairs/status/2093130747796148634RobinHeester29-08-2026
- Wapeniseert?? Dit is een erg onbetrouwbaar bericht. Niet alleen slecht vertaald, maar ook niet controleerbaar.Cas.v28-08-2026
- Niet mijn observatie dat de toeleveringsaanvoer stabiliseert.Cas.v26-08-2026